GPT Image 2.5 это семейство моделей OpenAI для генерации и редактирования картинок. В API ВЕГА доступны обе версии:
openai/gpt-image-2.5-flare, быстрая. Качество примерно как у GPT Image 2, но генерирует заметно быстрее. Подходит для черновиков, массовой генерации и всего, где важна скорость.openai/gpt-image-2.5-sunburst, качественная. Лучше держит сложные сцены, точные правки и мелкий текст. Стоит брать, когда Flare не дотягивает.Обе умеют генерировать с нуля, редактировать по референсным картинкам и делать прозрачный фон. Работают через один эндпоинт POST https://api.vega.chat/api/v1/images, оплата в рублях с баланса VEGA.
| Где генерируете | Сколько выходит |
|---|---|
| Офис ВЕГА (чат, без кода) | ~0,5 ₽ за картинку |
| API, базовый размер порядка 1K | ~3-4 ₽ |
| API, сложные промпты и сцены 2K и выше | от ~20 ₽ |
Разброс объяснимый: цена считается за токены, а их количество зависит от размера картинки и уровня quality. Простая картинка на medium стоит копейки, детализированная сцена на high или xhigh уходит дороже. Точная сумма каждого списания приходит в ответе в поле usage.cost (в долларах, до наценки VEGA).
Если нужна одна картинка «прямо сейчас» и не хочется писать код, дешевле сгенерировать её в Офисе ВЕГА. API нужен, когда генерация встроена в продукт: боты, карточки товаров, автопостинг, редактор.
VEGA_API_KEY. В коде и в git его не хардкодим.Минимальный запрос это model и prompt:
curl -X POST "https://api.vega.chat/api/v1/images" \
  -H "Authorization: Bearer $VEGA_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "openai/gpt-image-2.5-flare",
    "prompt": "Красная панда-астронавт парит в открытом космосе, студийное освещение",
    "aspect_ratio": "1:1",
    "quality": "medium"
  }'
Картинка приходит не ссылкой, а прямо в ответе, в base64:
{
  "created": 1788916400,
  "data": [
    {
      "b64_json": "<base64-картинки>",
      "media_type": "image/png"
    }
  ],
  "usage": {
    "prompt_tokens": 24,
    "completion_tokens": 4175,
    "total_tokens": 4199,
    "cost": 0.04
  }
}
Чтобы получить файл, декодируем b64_json. На Python это три строки:
import base64

with open("panda.png", "wb") as f:
    f.write(base64.b64decode(result["data"][0]["b64_json"]))
Поле media_type подсказывает формат: image/png, image/jpeg, image/webp. Сохраняйте файл с расширением из этого поля.
Кроме model и prompt модель принимает:
| Параметр | Значения | Зачем |
|---|---|---|
aspect_ratio | 1:1, 3:2, 2:3, 4:3, 3:4, 16:9, 9:16, 21:9, auto | Соотношение сторон. auto отдаёт выбор провайдеру |
quality | auto, low, medium, high, xhigh, max | Уровень детализации. Сильнее всего влияет на цену и время |
background | auto, transparent, opaque | Прозрачный фон работает только с png и webp |
n | 1-10 | Сколько вариантов сгенерировать за один запрос |
input_references | до 16 картинок | Референсы для редактирования, URL или base64 |
output_format | png, jpeg, webp | Формат файла на выходе |
output_compression | 0-100 | Сжатие для jpeg и webp. Для png игнорируется |
stream | true / false | Стриминг промежуточных рендеров по SSE |
Рабочая связка для старта: quality: "medium" для прогонов и high для финального варианта. xhigh и max имеет смысл включать только когда high реально не хватило: с ними растут и цена, и время генерации, а картинка не всегда становится лучше.
Пример с несколькими параметрами. Логотип на прозрачном фоне, четыре варианта:
{
  "model": "openai/gpt-image-2.5-sunburst",
  "prompt": "Создай оригинальный логотип для локальной пекарни «Поле и мука» (Field & Flour). Тёплый, простой, вне времени. Чистые векторные формы, сильный силуэт, сбалансированное негативное пространство. Плоский дизайн, минимум линий, без градиентов. Полностью прозрачный фон, один логотип по центру с большими полями, чистые края по альфа-каналу, без шахматного фона и водяных знаков.",
  "aspect_ratio": "1:1",
  "quality": "medium",
  "background": "transparent",
  "output_format": "png",
  "n": 4
}
Вот что отдали обе модели на такой запрос (вариант из четырёх):
| Flare | Sunburst |
|---|---|
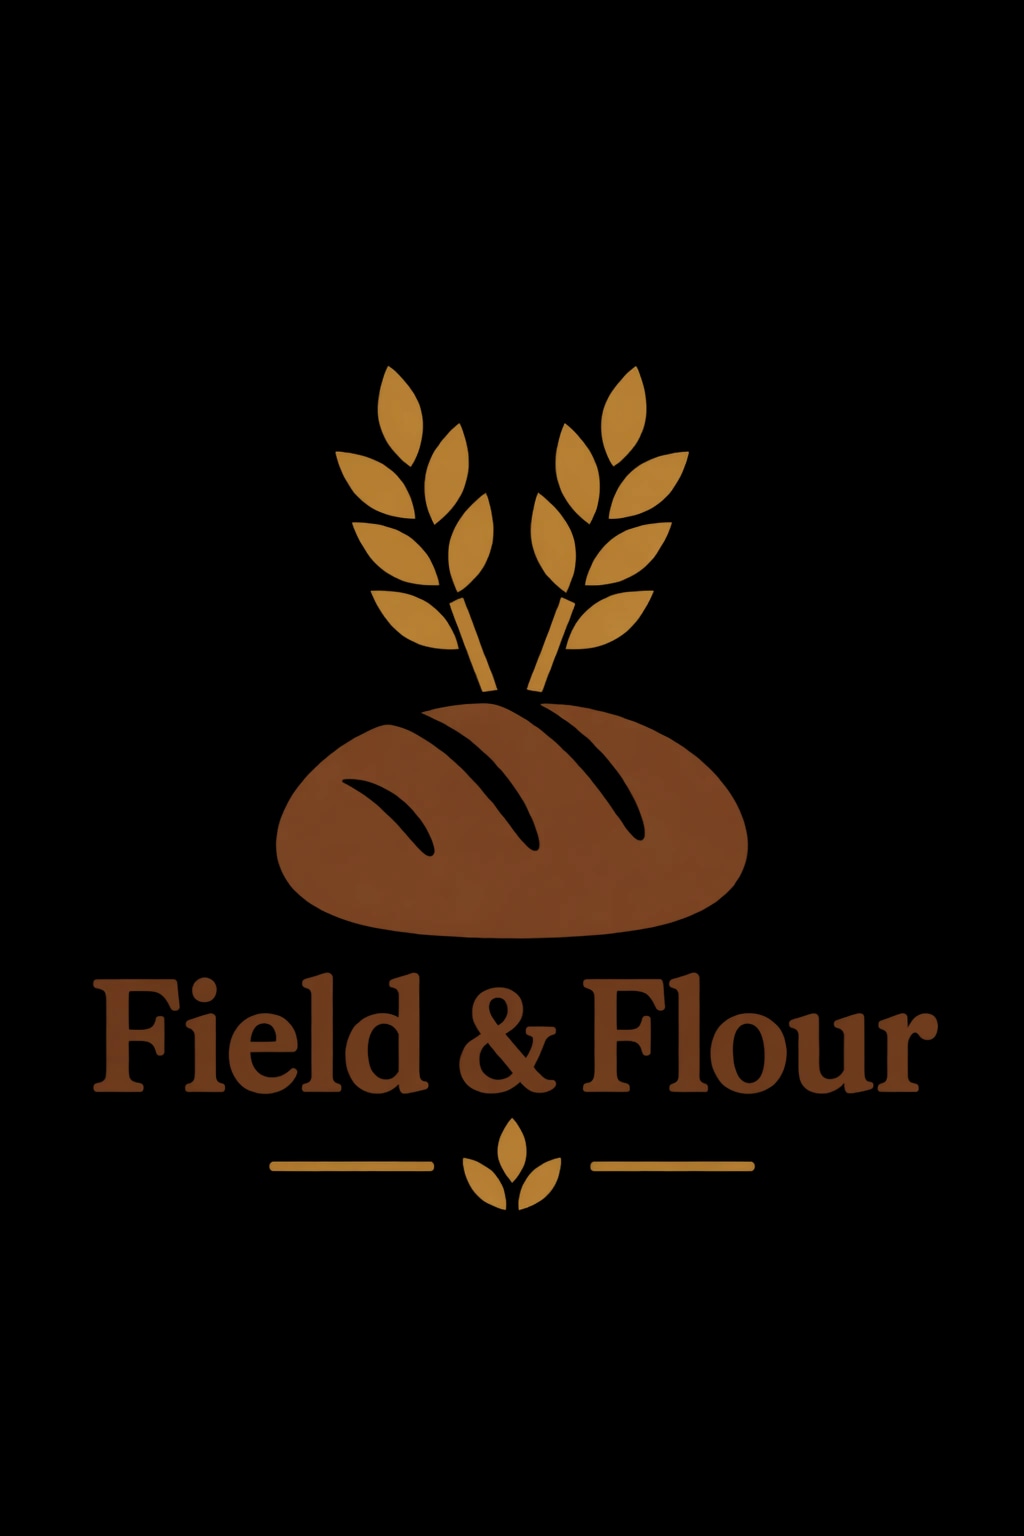 | 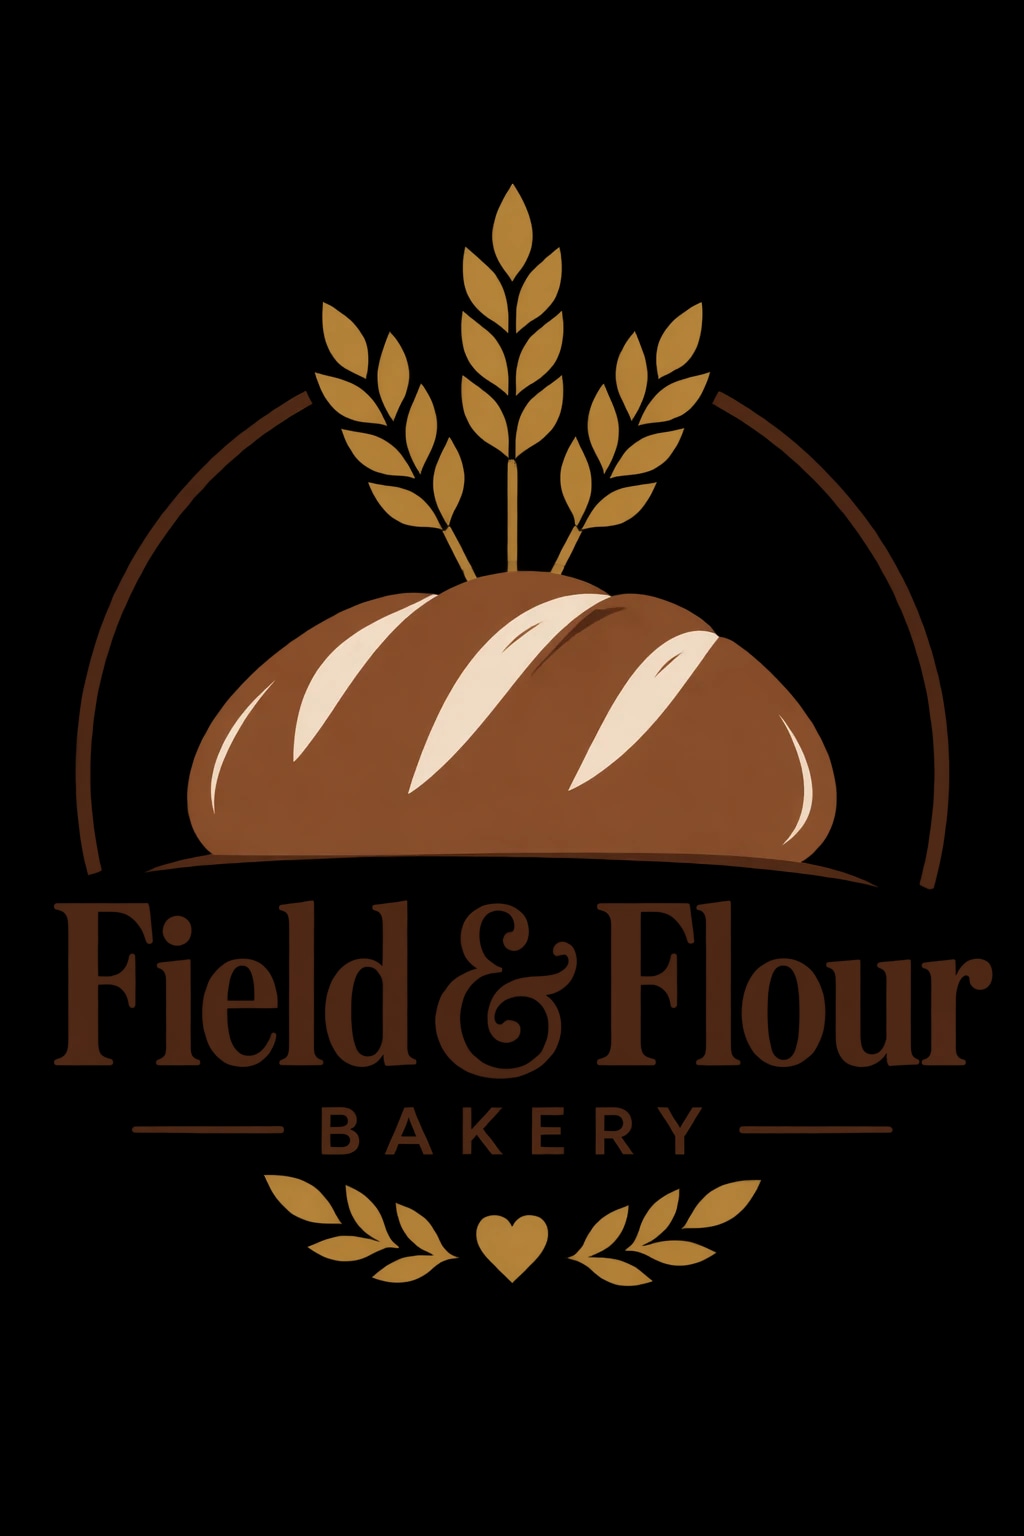 |
Нюанс с прозрачностью: нарисованный шахматный фон это не прозрачность. Проверяйте альфа-канал в файле, особенно по краям объекта, волосам и стеклу.
import base64
import requests

response = requests.post(
    "https://api.vega.chat/api/v1/images",
    headers={
        "Authorization": "Bearer <VEGA_API_KEY>",
        "Content-Type": "application/json",
    },
    json={
        "model": "openai/gpt-image-2.5-flare",
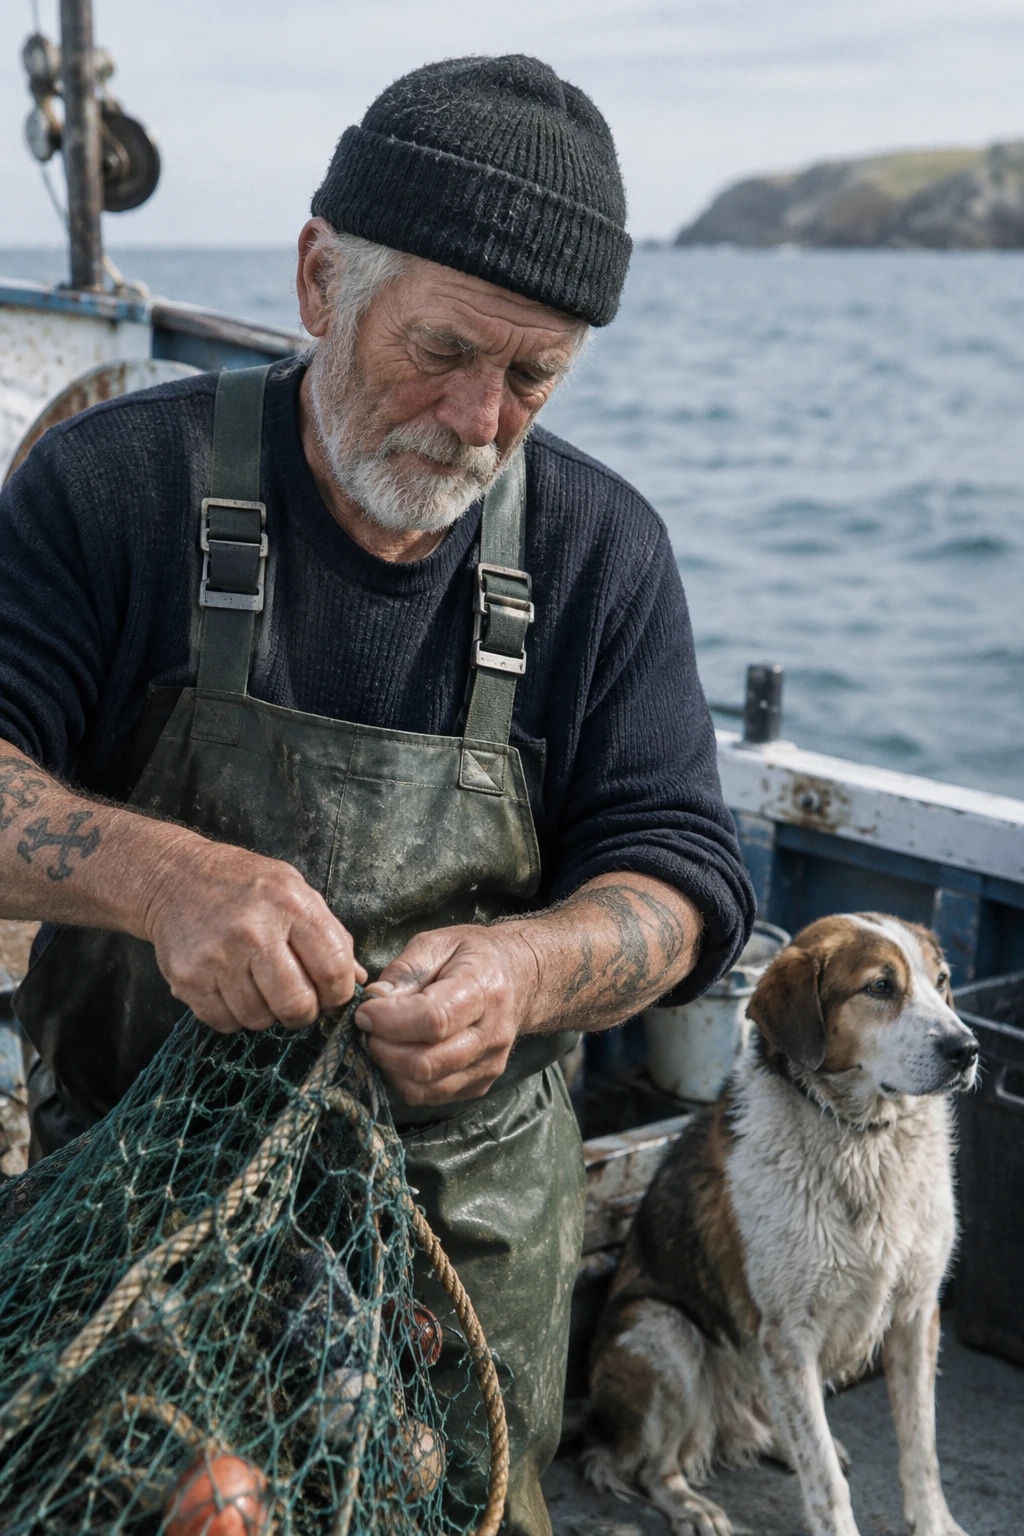
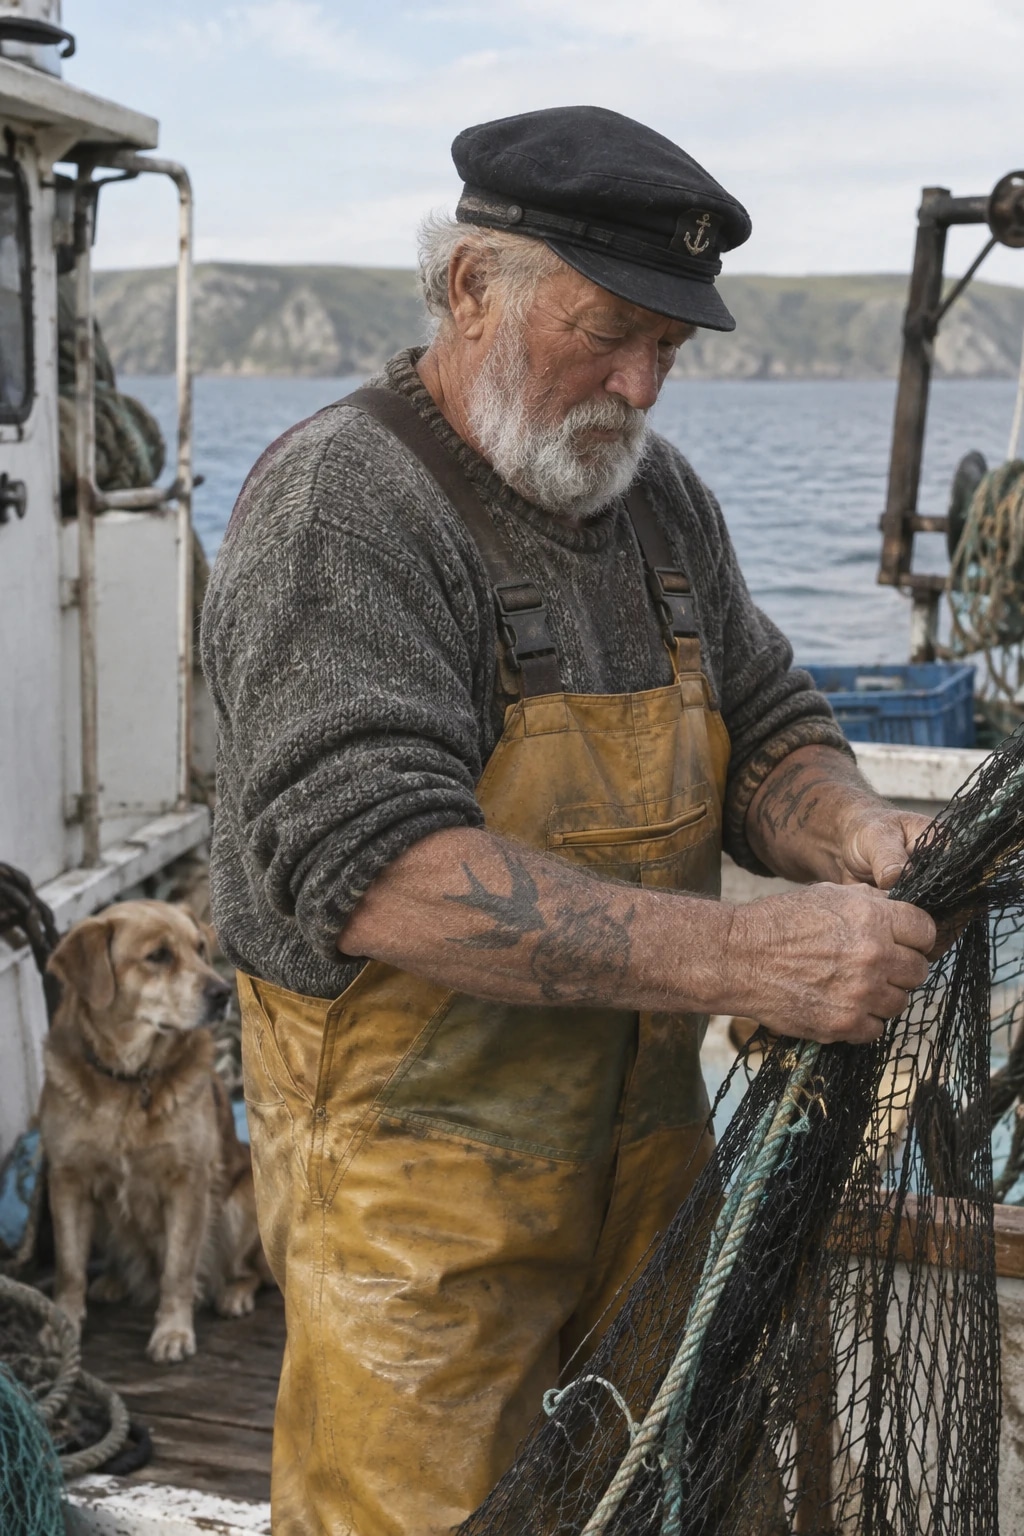
        "prompt": "Фотореалистичный снимок пожилого моряка на рыбацкой лодке. "
                  "Он спокойно чинит сеть, рядом на палубе сидит пёс. "
                  "Как на 35-мм плёнку, средний план, объектив 50 мм, "
                  "мягкий прибрежный свет, лёгкое зерно, естественные цвета. "
                  "Без гламура и тяжёлой ретуши.",
        "aspect_ratio": "2:3",
        "quality": "medium",
    },
)

result = response.json()
for i, image in enumerate(result["data"], start=1):
    with open(f"sailor-{i}.png", "wb") as f:
        f.write(base64.b64decode(image["b64_json"]))
Результат этого промпта:
| Flare | Sunburst |
|---|---|
 |  |
const response = await fetch('https://api.vega.chat/api/v1/images', {
  method: 'POST',
  headers: {
    Authorization: `Bearer ${process.env.VEGA_API_KEY}`,
    'Content-Type': 'application/json',
  },
  body: JSON.stringify({
    model: 'openai/gpt-image-2.5-flare',
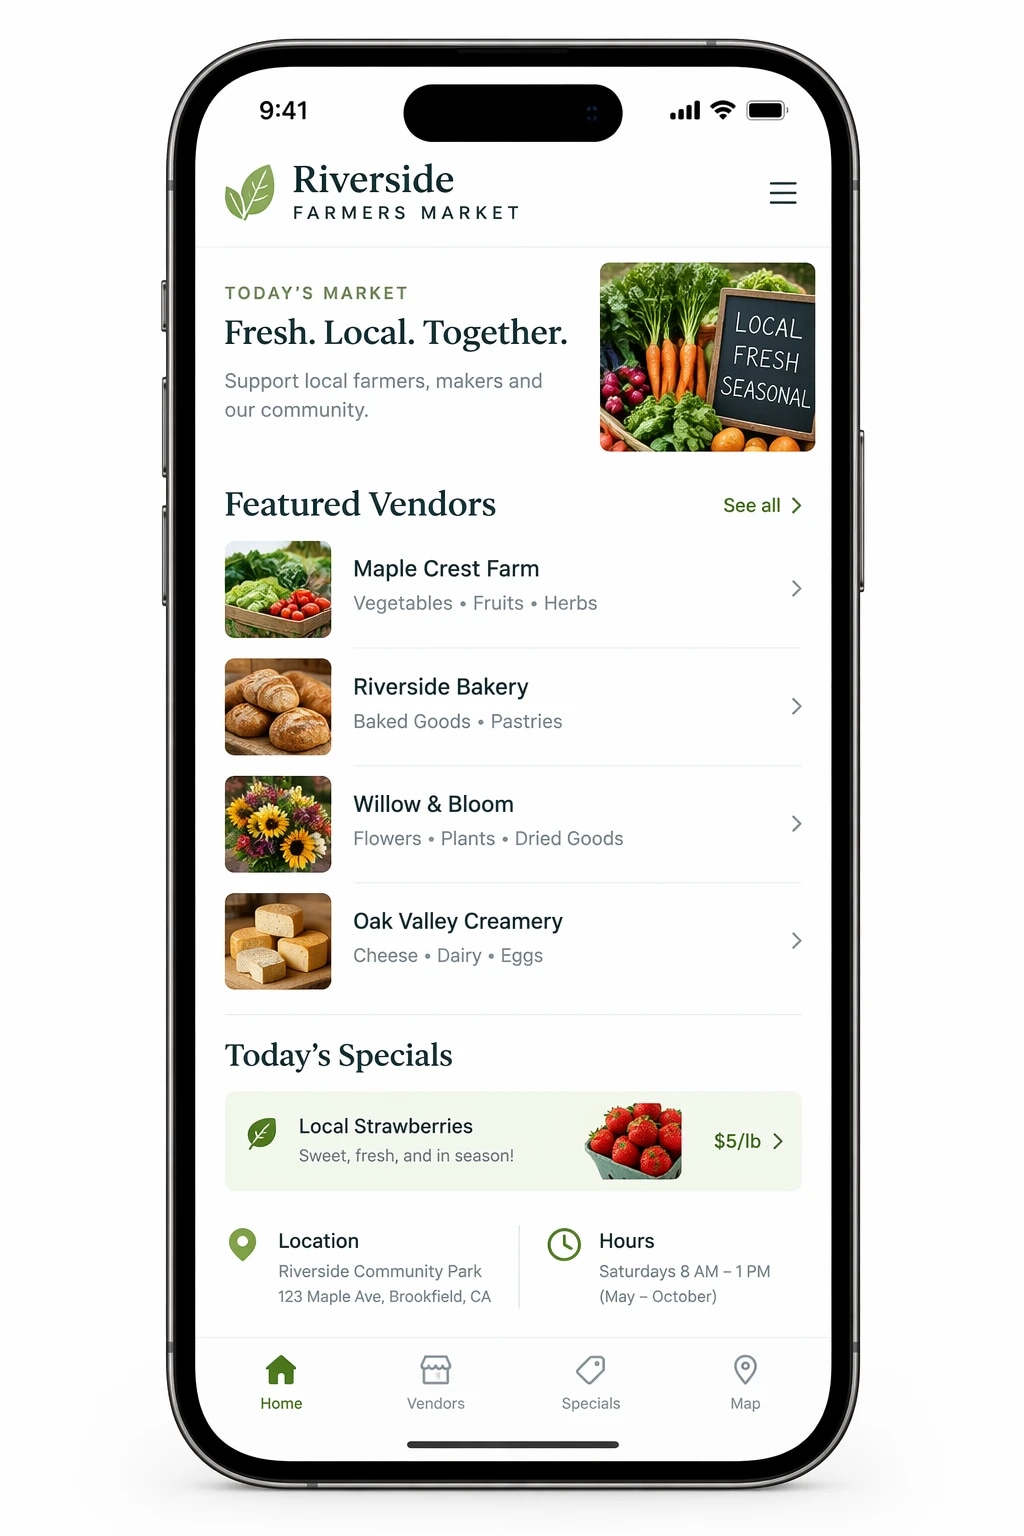
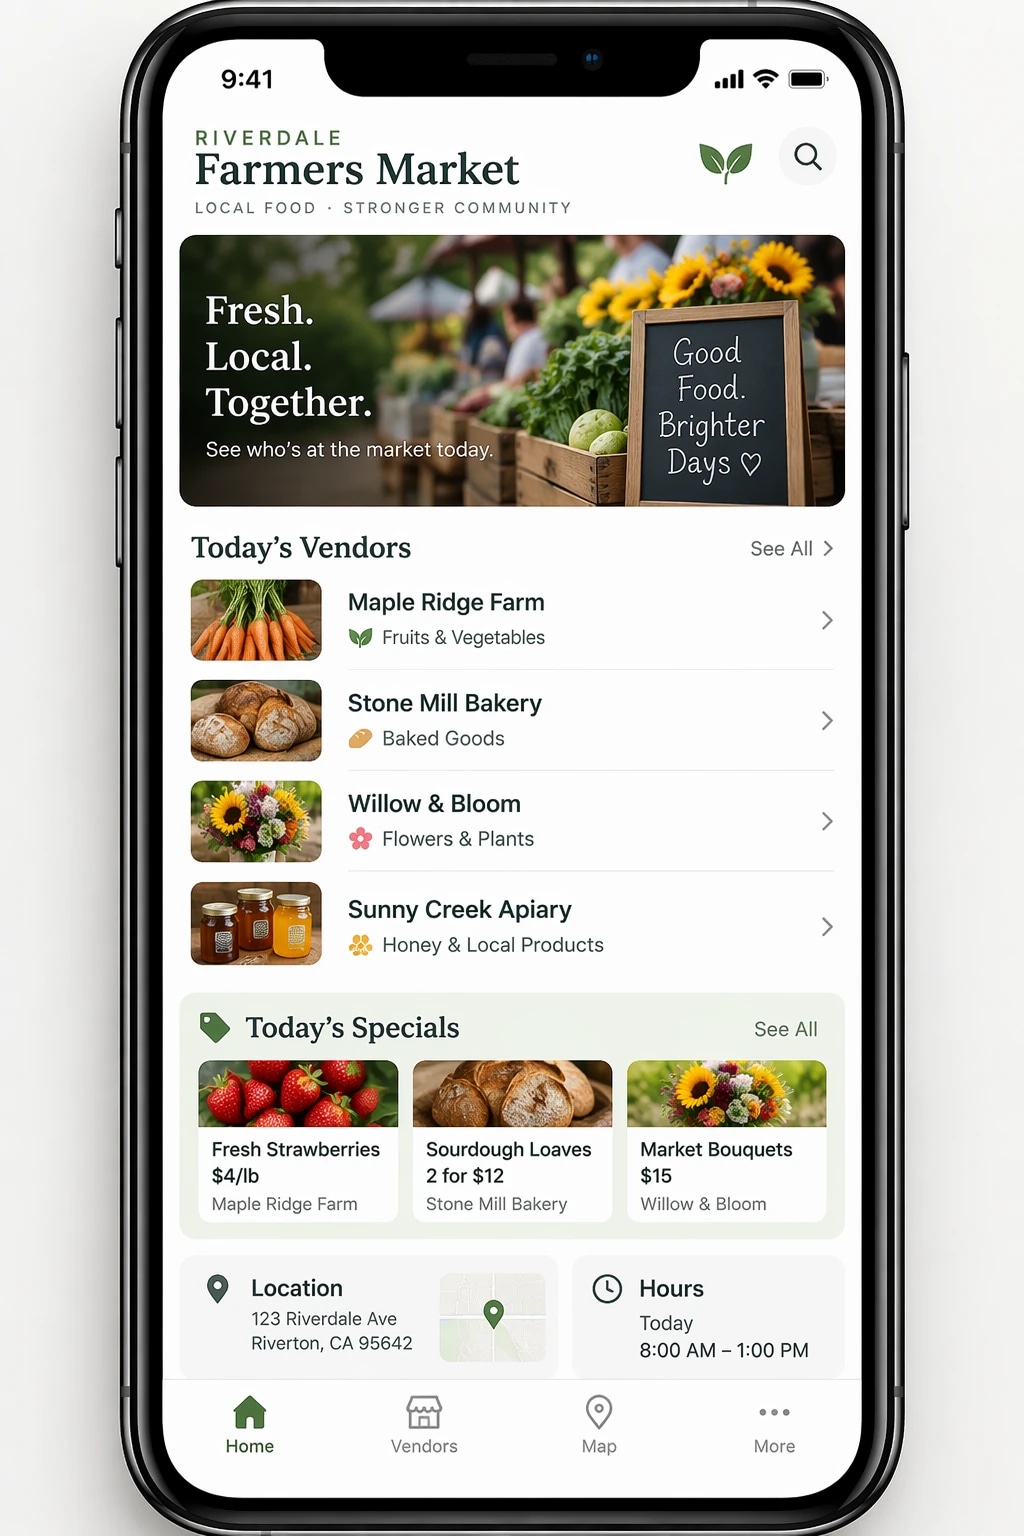
    prompt: 'UI-мокап мобильного приложения фермерского рынка: ' +
      'шапка, список продавцов с фото и категориями, блок «Сегодняшние скидки», ' +
      'адрес и часы работы. Белый фон, спокойные природные акценты, ' +
      'аккуратная типографика, минимум декора. Мокап внутри рамки iPhone.',
    aspect_ratio: '2:3',
    quality: 'medium',
  }),
});

const result = await response.json();
const image = result.data[0];
// image.b64_json это base64-картинка, image.media_type её формат
require('fs').writeFileSync('market-ui.png', Buffer.from(image.b64_json, 'base64'));| Flare | Sunburst |
|---|---|
 |  |
В API ВЕГА эндпоинт /api/v1/images/generations повторяет формат OpenAI Images API и работает как алиас /api/v1/images. Поэтому обычный OpenAI SDK заводится сменой base_url:
from openai import OpenAI

client = OpenAI(
    base_url="https://api.vega.chat/api/v1",
    api_key="<VEGA_API_KEY>",
)

result = client.images.generate(
    model="openai/gpt-image-2.5-sunburst",
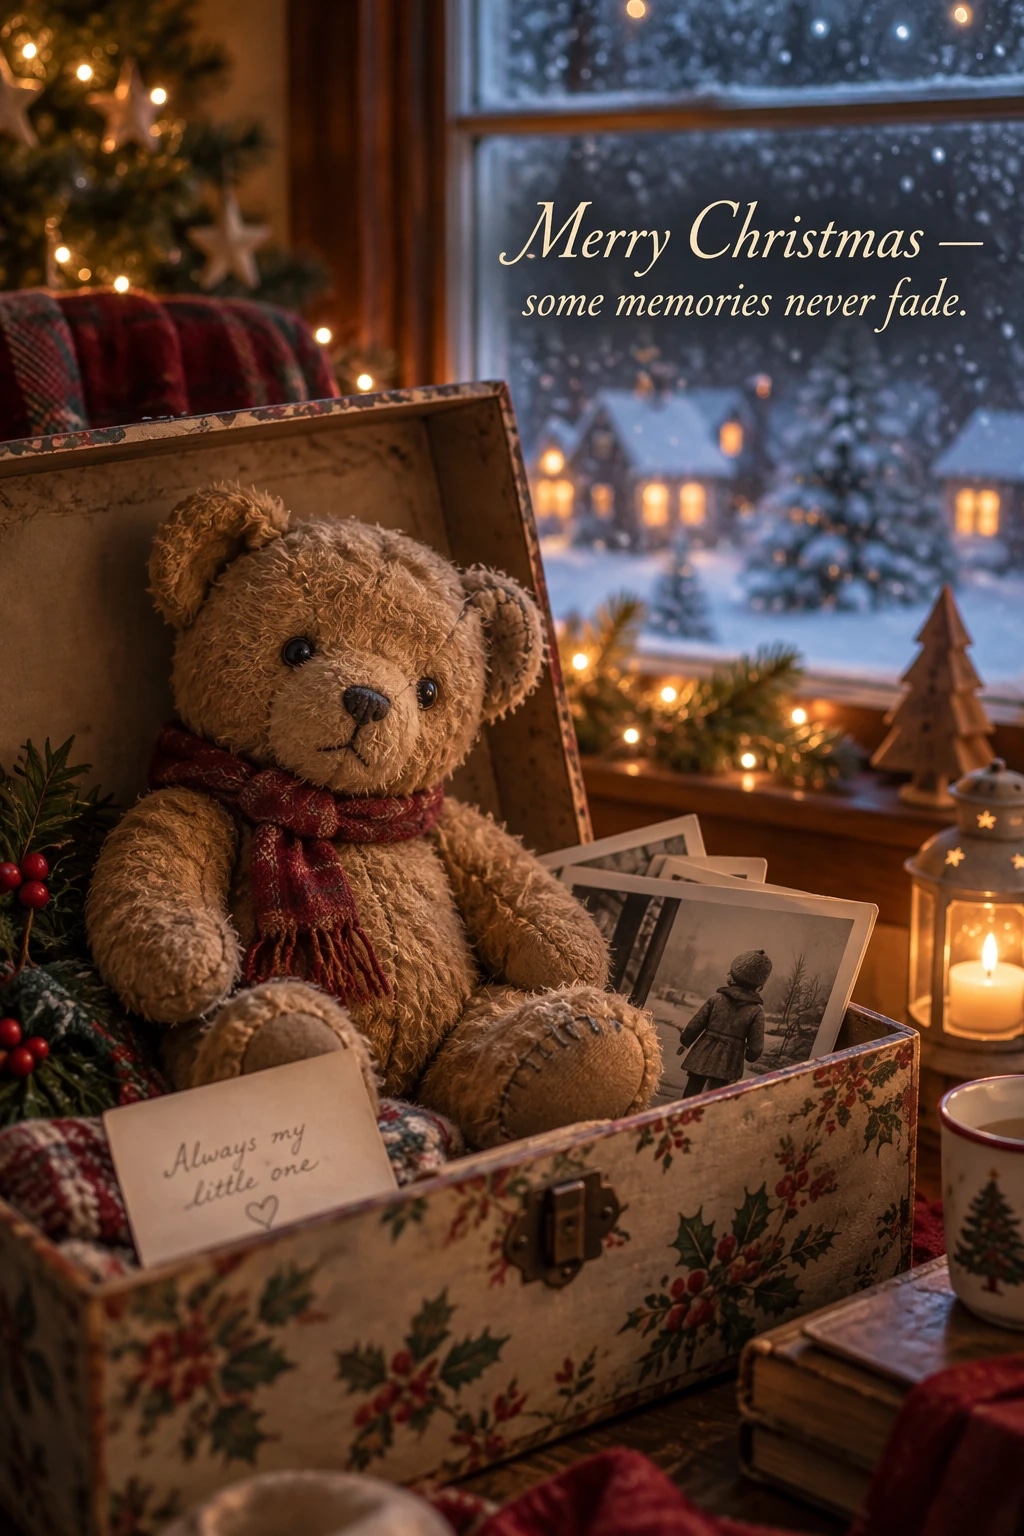
    prompt="Праздничная открытка: старый плюшевый мишка сидит в коробке "
           "у окна, за окном падает снег. Тёплая ностальгическая сцена, "
           "мягкий кинематографичный свет, реалистичные текстуры, "
           "малая глубина резкости. Текст на открытке дословно: "
           "\"С Рождеством: некоторые воспоминания не исчезают.\"",
    size="1024x1536",
    quality="medium",
)| Результат |
|---|
 |
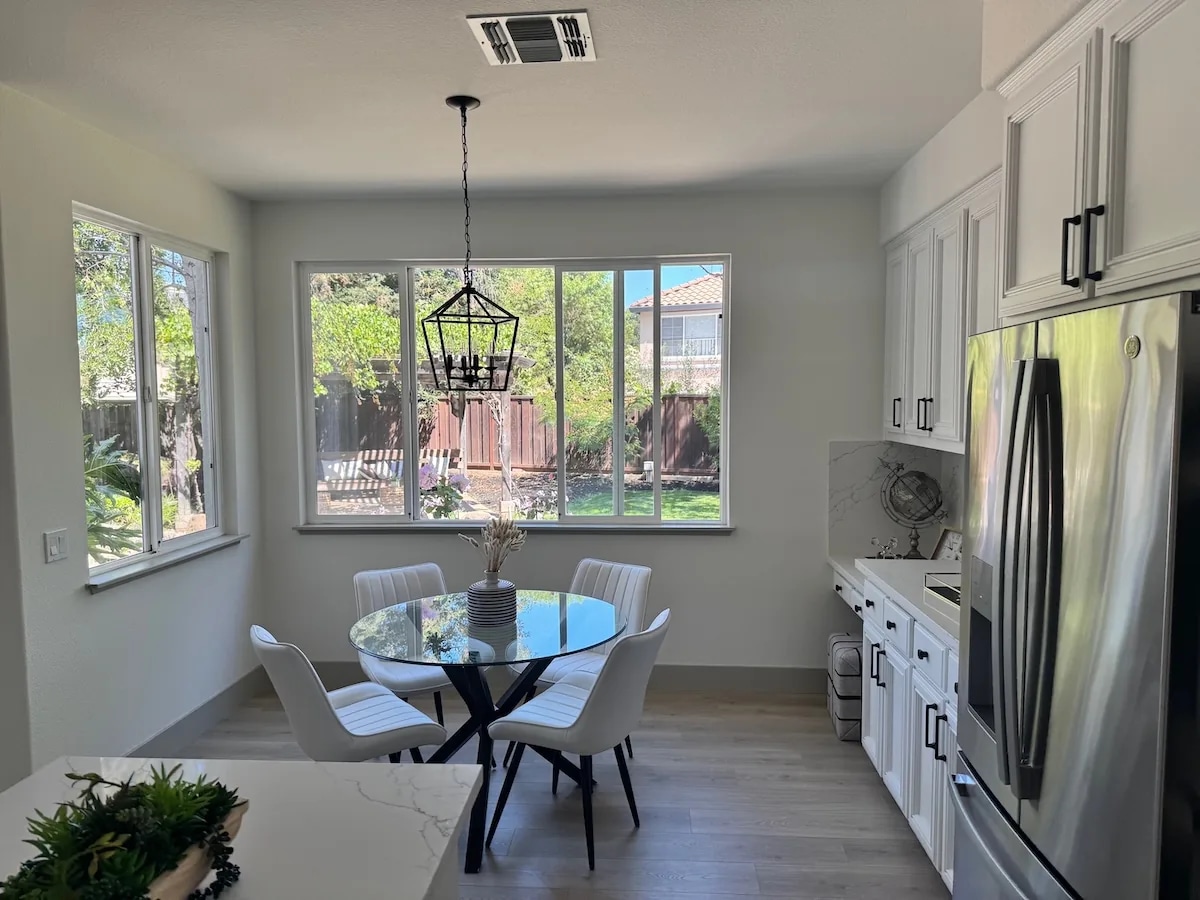
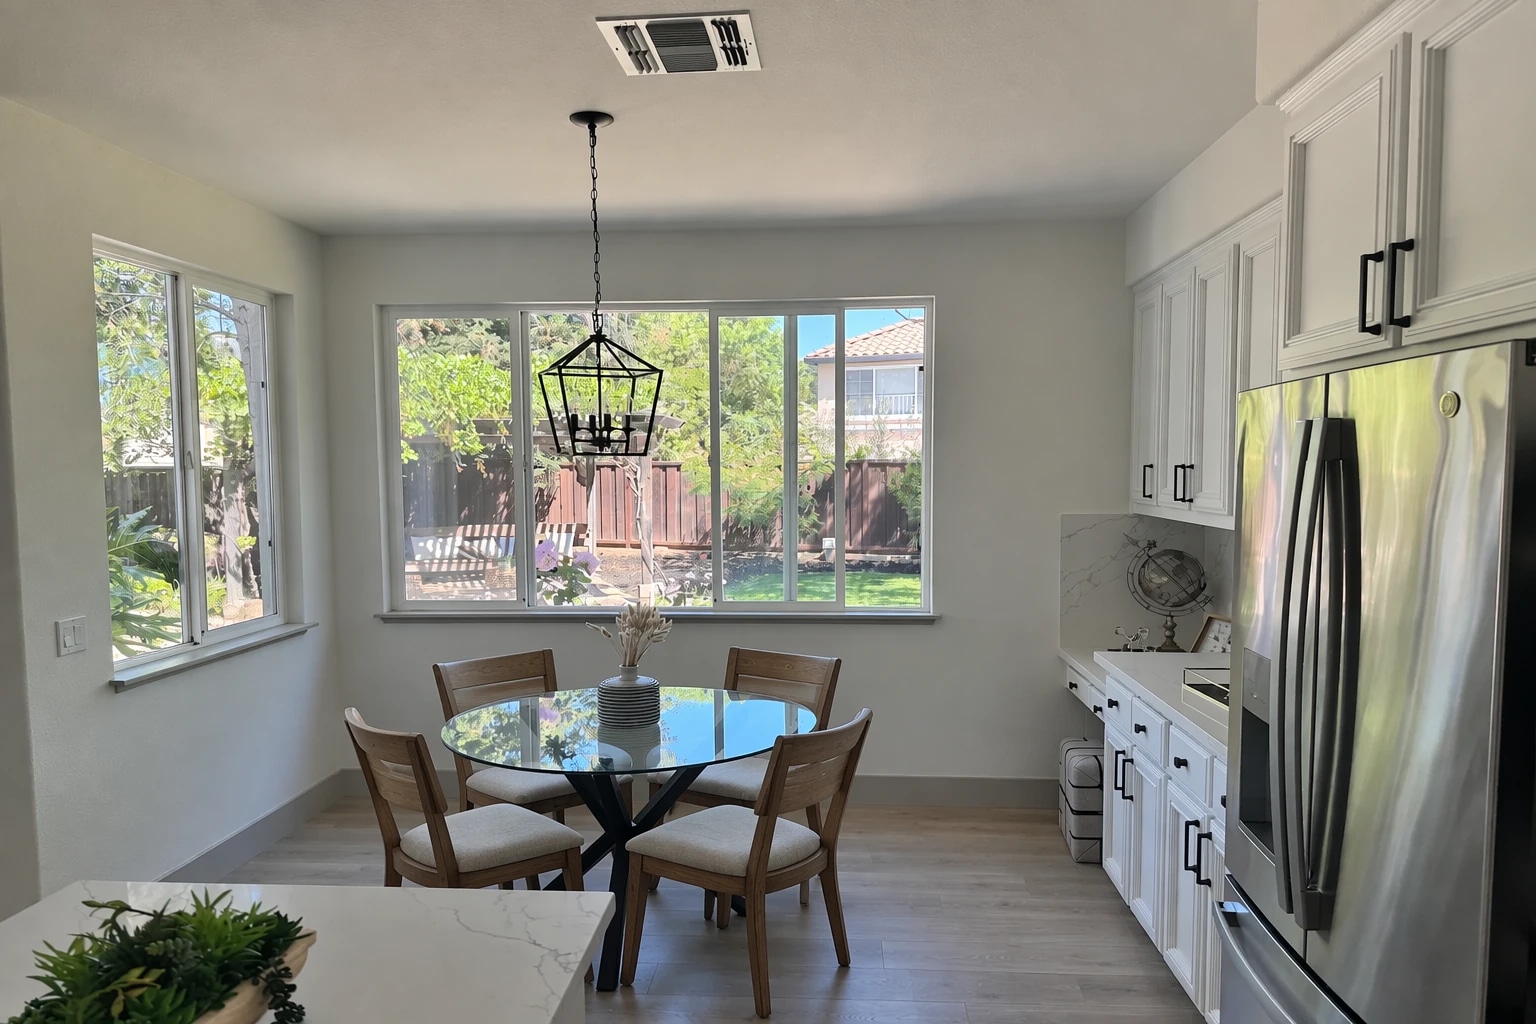
Отдельного эндпоинта для правок нет: в тот же POST /api/v1/images передаём input_references. Это массив картинок, до 16 штук, каждая как URL или base64 data URL. В промпте прописываем, что поменять и что сохранить.
response = requests.post(
    "https://api.vega.chat/api/v1/images",
    headers={
        "Authorization": "Bearer <VEGA_API_KEY>",
        "Content-Type": "application/json",
    },
    json={
        "model": "openai/gpt-image-2.5-sunburst",
        "prompt": "Замени ТОЛЬКО белые стулья на деревянные. "
                  "Сохрани ракурс камеры, освещение комнаты, тени на полу "
                  "и окружающие предметы. Фотореалистичные контактные тени "
                  "и текстура дерева.",
        "input_references": [
            {
                "type": "image_url",
                "image_url": {"url": "https://example.com/kitchen.jpg"},
            }
        ],
        "quality": "medium",
    },
)| Исходник | Flare | Sunburst |
|---|---|---|
 |  |  |
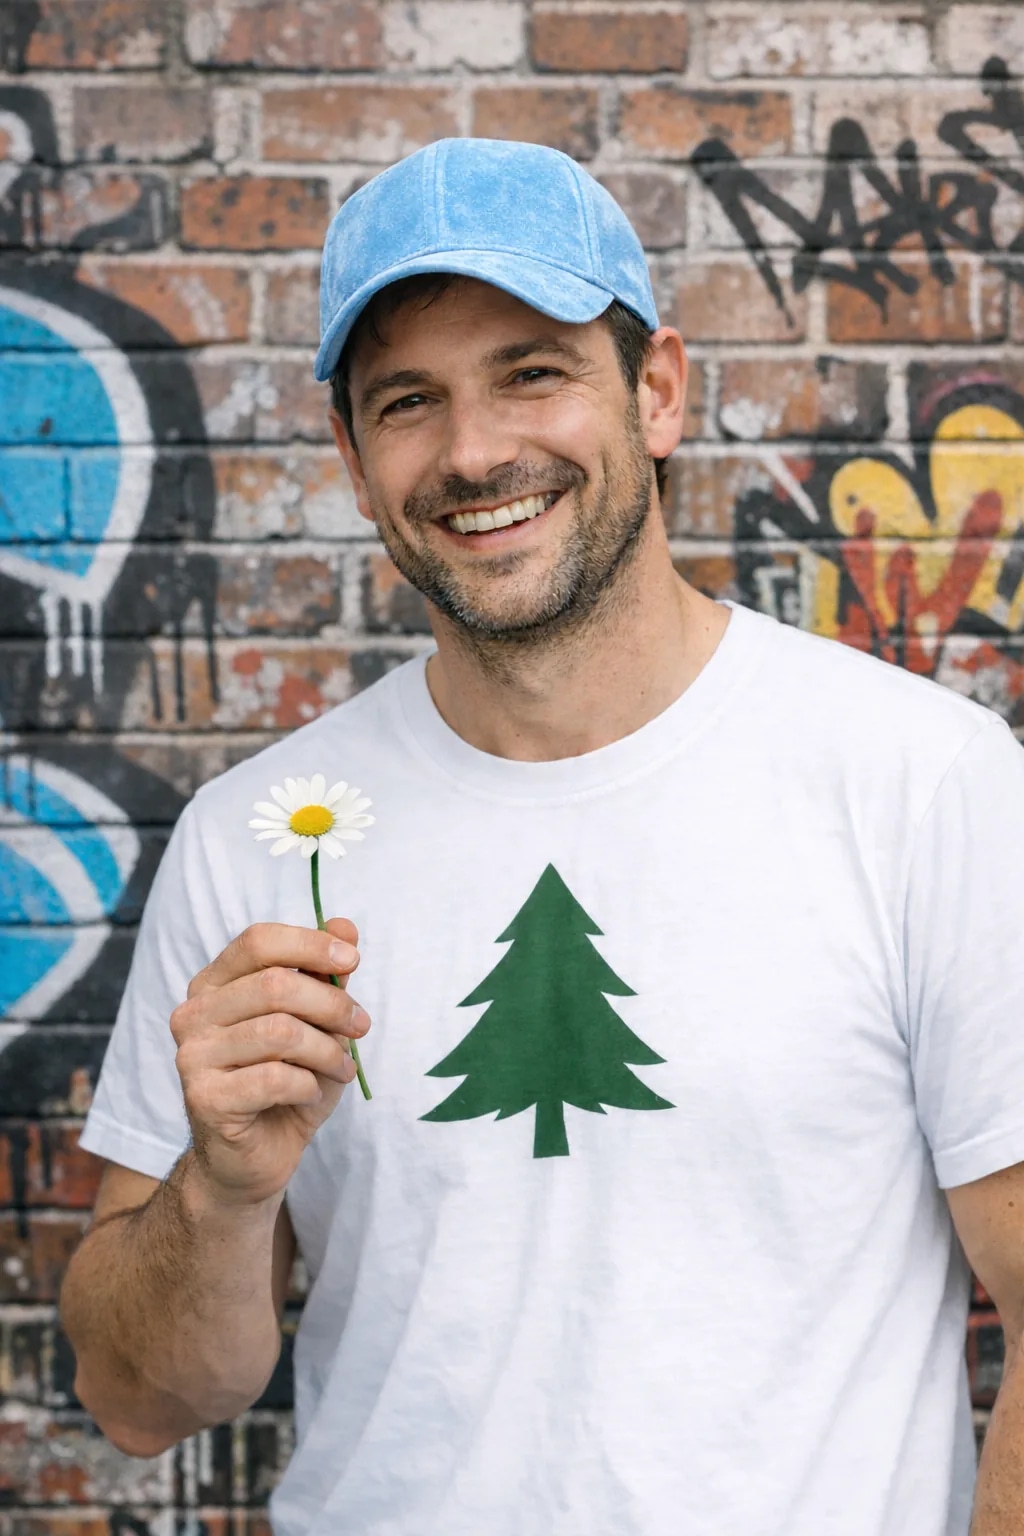
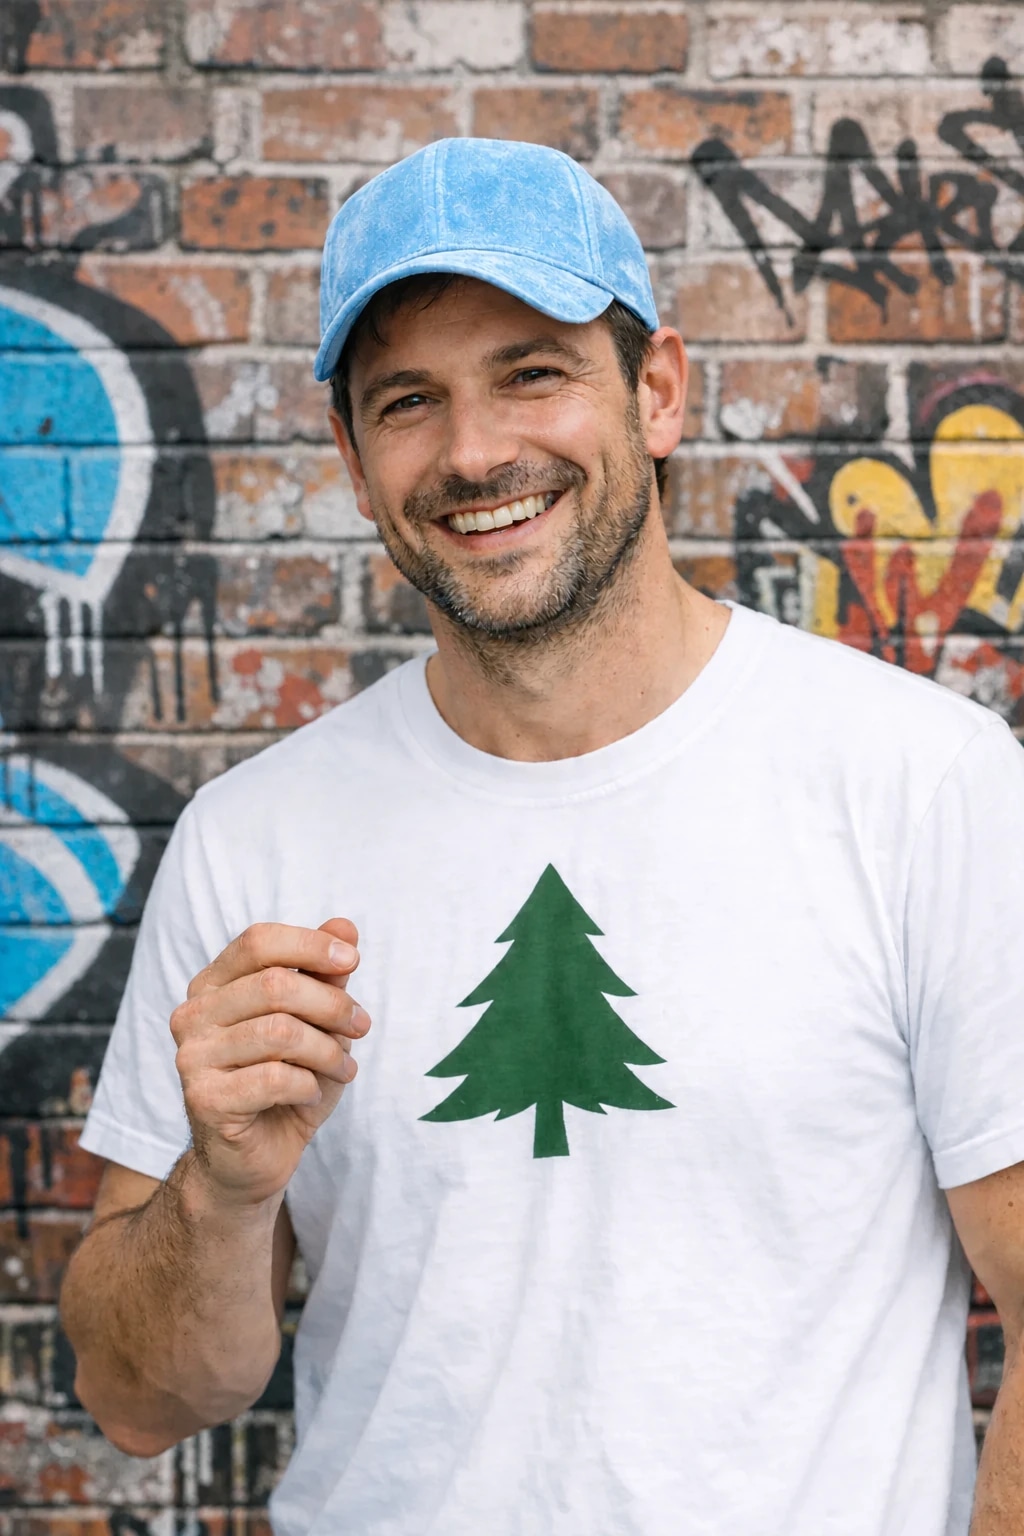
Локальный файл тоже работает, его нужно завернуть в data URL:
import base64

with open("photo.jpg", "rb") as f:
    data_url = "data:image/jpeg;base64," + base64.b64encode(f.read()).decode()

payload = {
    "model": "openai/gpt-image-2.5-sunburst",
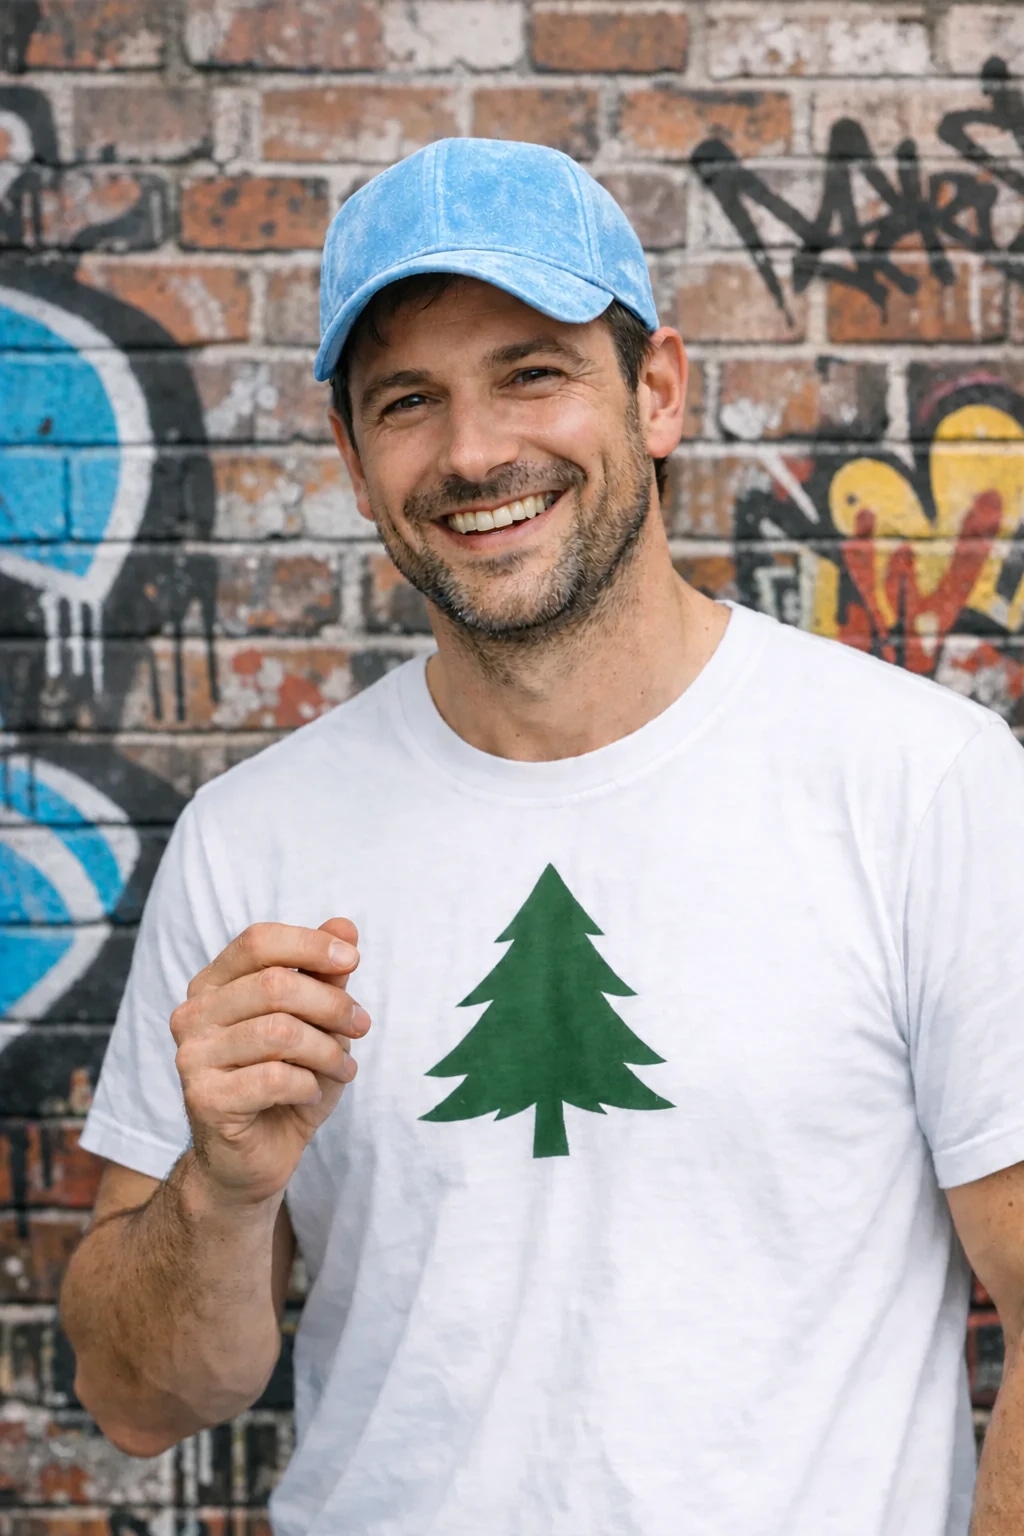
    "prompt": "Убери цветок из руки мужчины. Больше ничего не меняй.",
    "input_references": [
        {"type": "image_url", "image_url": {"url": data_url}}
    ],
}| Исходник | Flare | Sunburst |
|---|---|---|
 |  |  |
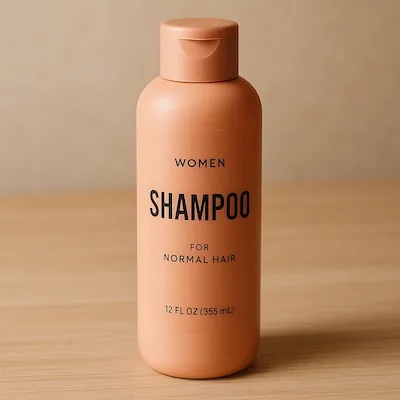
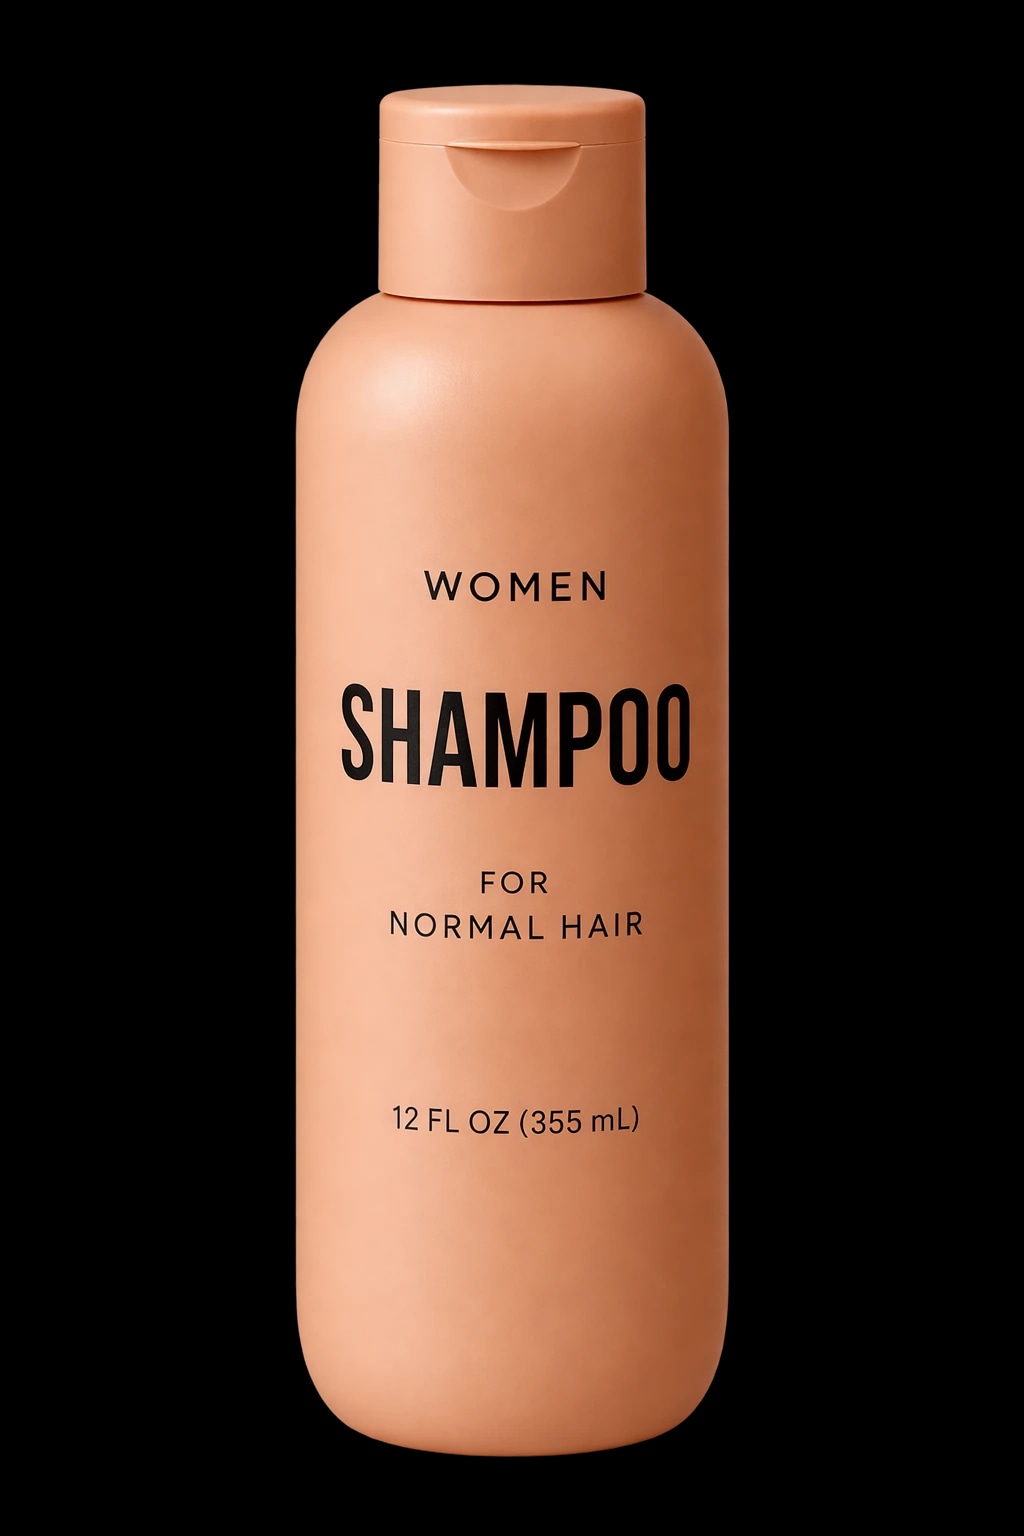
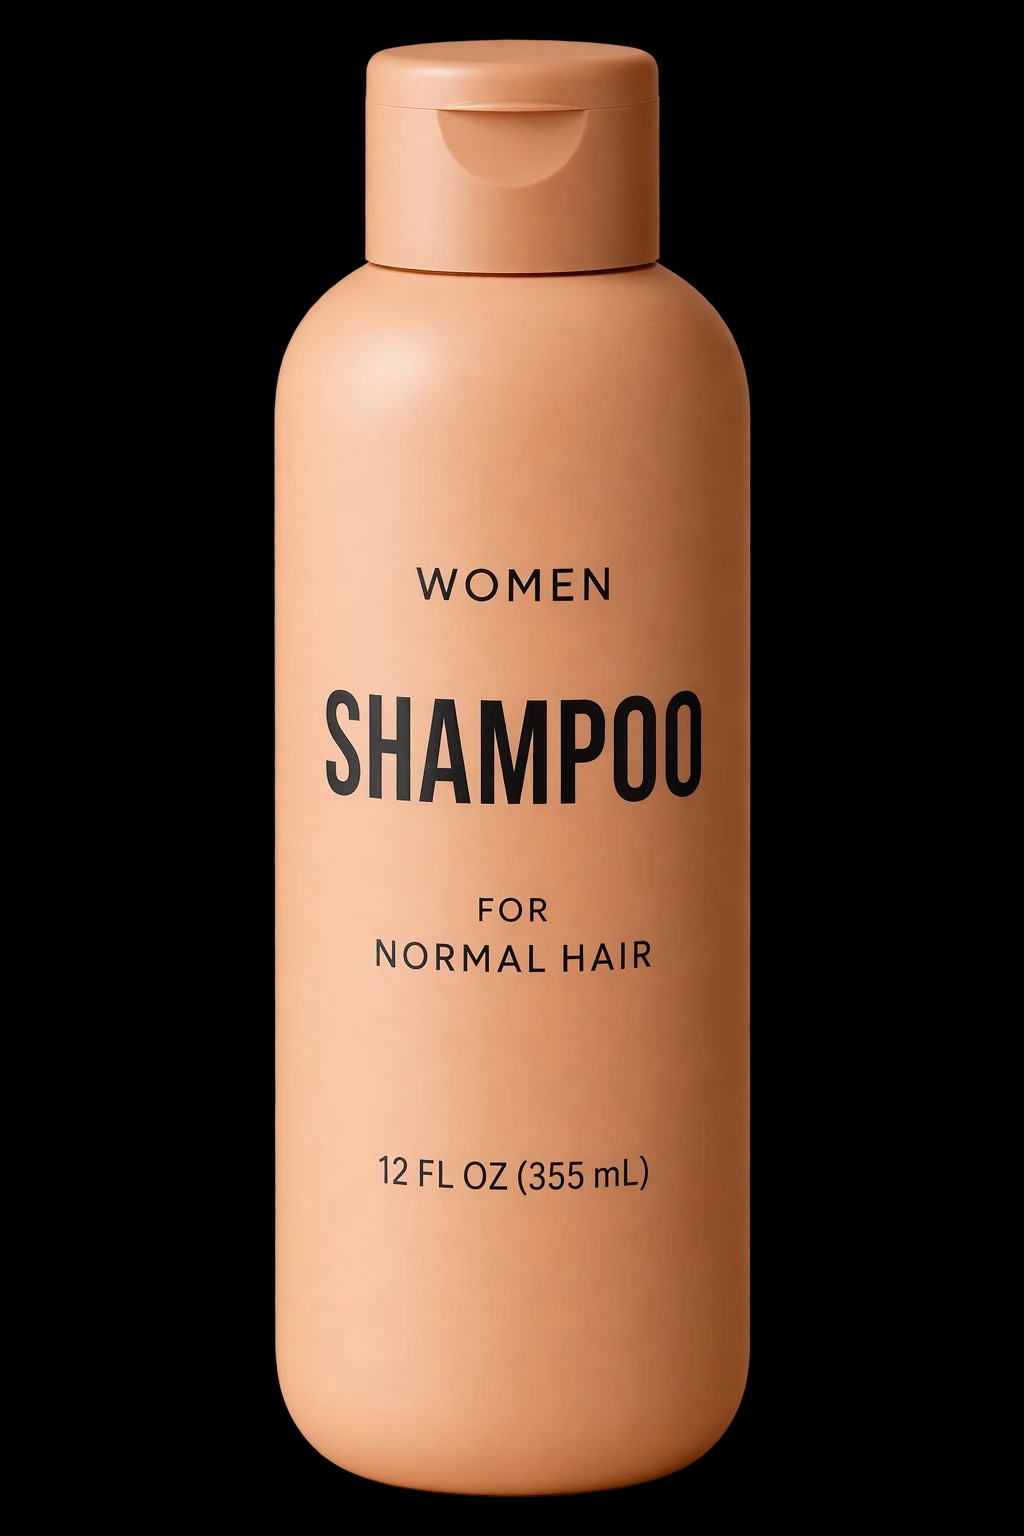
Вырежи товар со входного изображения и изолируй его на полностью
прозрачном фоне.
На выходе: товар по центру, чёткий силуэт, без ореолов и каймы.
Сохрани геометрию товара и читаемость этикетки один в один.
Только лёгкая чистка. Не добавляй сплошной фон, шахматку, декорации
и тени. Не переоформляй товар.
Здесь в запросе обязательно background: "transparent" и output_format: "png" (или webp), иначе альфа-канала не будет:
| Исходник | Flare | Sunburst |
|---|---|---|
 |  |  |
Когда референсов несколько, пронумеруйте их в промпте и назначьте роль каждому: «из первого изображения возьми персонажа, из второго стиль, из третьего фон». Так модель не смешает входы в кучу.
Обе модели поддерживают stream: true. Ответ приходит как SSE-поток с промежуточными рендерами, удобно показывать прогресс в интерфейсе:
curl -N -X POST "https://api.vega.chat/api/v1/images" \
  -H "Authorization: Bearer $VEGA_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "openai/gpt-image-2.5-flare",
    "prompt": "Детализированный пейзаж в стиле акварели",
    "stream": true
  }'
В потоке три типа событий: image_generation.partial_image (промежуточный кадр), image_generation.completed (финальная картинка с usage.cost) и error, если генерация сломалась. Поток заканчивается data: [DONE].
Главная мысль из официального гайда OpenAI: промпт это техническое задание, а не пожелание. Что работает на практике:
Назовите результат. Не «нарисуй картинку», а «фотография товара для карточки на маркетплейсе» или «слайд для питч-дека». Модель по-разному компонует кадр под разные задачи.
Разложите сцену по секциям. Для сложных запросов пишите блоками: сцена, объект, детали, ограничения. Можно обычным текстом с подписями, хоть JSON-подобной структурой. Важна читаемость, а не синтаксис.
Описывайте видимое. Материалы, свет, цвета, ракурс. Если нужен фотореализм, пишите «фотореалистичный снимок» или «реальная фотография» прямо. Слова про настроение («эпично», «уютно») без конкретики почти не работают, заменяйте их масштабом, атмосферой и цветом.
Текст на картинке берите в кавычки. Дословно, с указанием, где он стоит и как выглядит:
Текст на билборде (ДОСЛОВНО, без лишних символов):
"Свежесть и чистота"
Типографика: жирный гротеск, высокий контраст, по центру.
Текст должен появиться ровно один раз и идеально читаться.
Без водяных знаков и логотипов.
Бренды и необычные слова лучше проговорить по буквам. Мелкий текст, плотные схемы и несколько шрифтов требуют quality: "high" и выше.
Людей описывайте телом. «В полный рост, ступни в кадре», «смотрит вниз на открытую книгу», «руки естественно лежат на руле». Без этого модель сама решает, что делать с конечностями, и решение вам не всегда понравится.
В правках отделяйте изменения от запретов. Схема «измени только X, остальное сохрани» работает надёжнее длинного описания нового результата. Перечислите, что должно остаться: лицо, ракурс, свет, композиция, подписи. Как в примере выше со стульями: половина промпта это список того, что менять нельзя.
Итерируйте по одному изменению. Получили результат, подали его как input_references, попросили одну правку. Модель хорошо держит контекст («в том же стиле»), но критичные ограничения повторяйте в каждом запросе: при длинной цепочке правок детали всё равно плывут.
Для проверки результата держите короткий чеклист: текст без опечаток и читаем, лицо и продукт не исказились, правка затронула только то, что просили, прозрачный фон это реальный альфа-канал, а не шахматка.
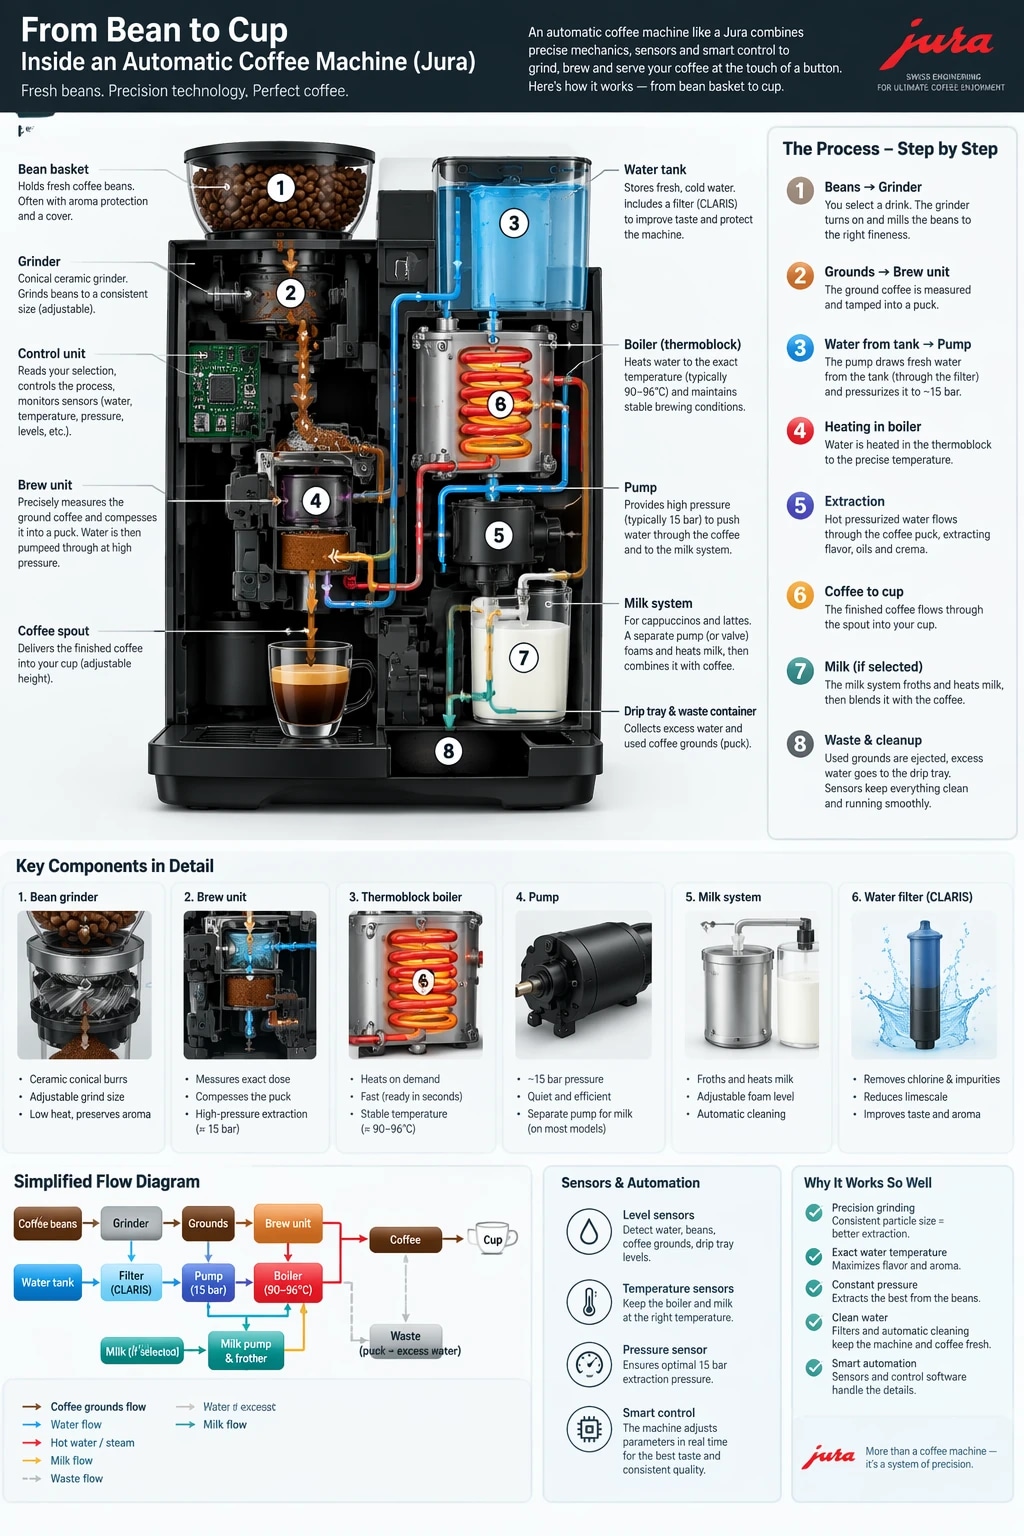
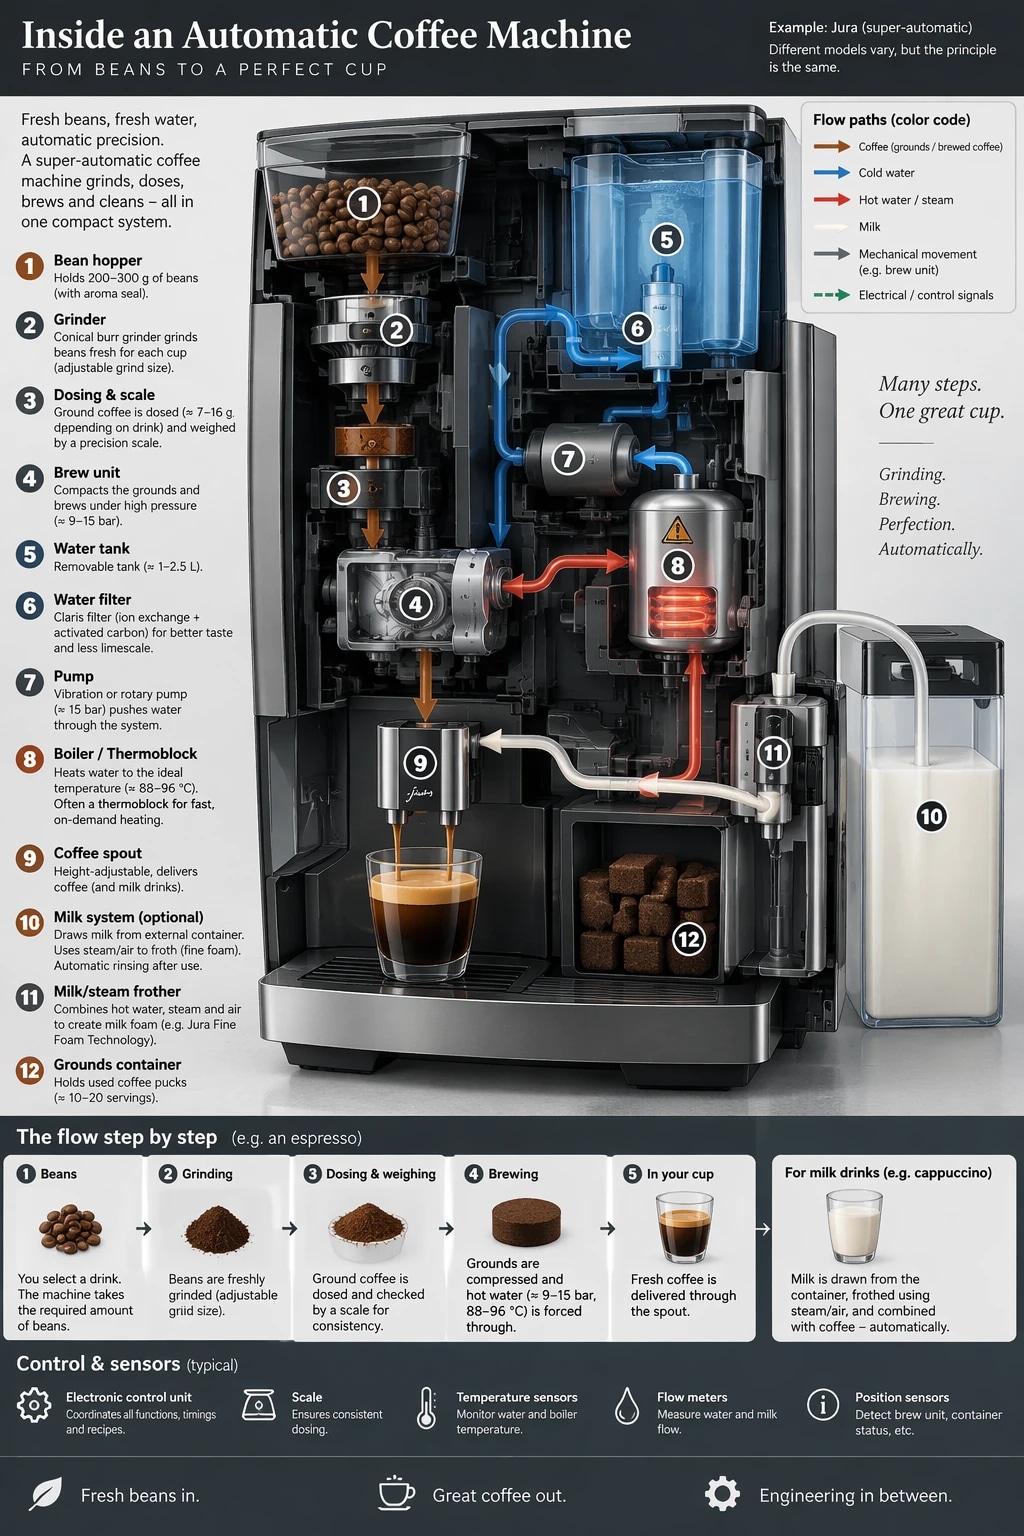
Модель хорошо строит диаграммы, если назвать тему, аудиторию и что должно быть понятно со схемы:
Создай подробную инфографику о работе автоматической кофемашины
вроде Jura. От контейнера для зёрен к помолу, весам, резервуару
для воды, бойлеру и так далее. Хочу понять весь процесс технически
и визуально.| Flare | Sunburst |
|---|---|
 |  |
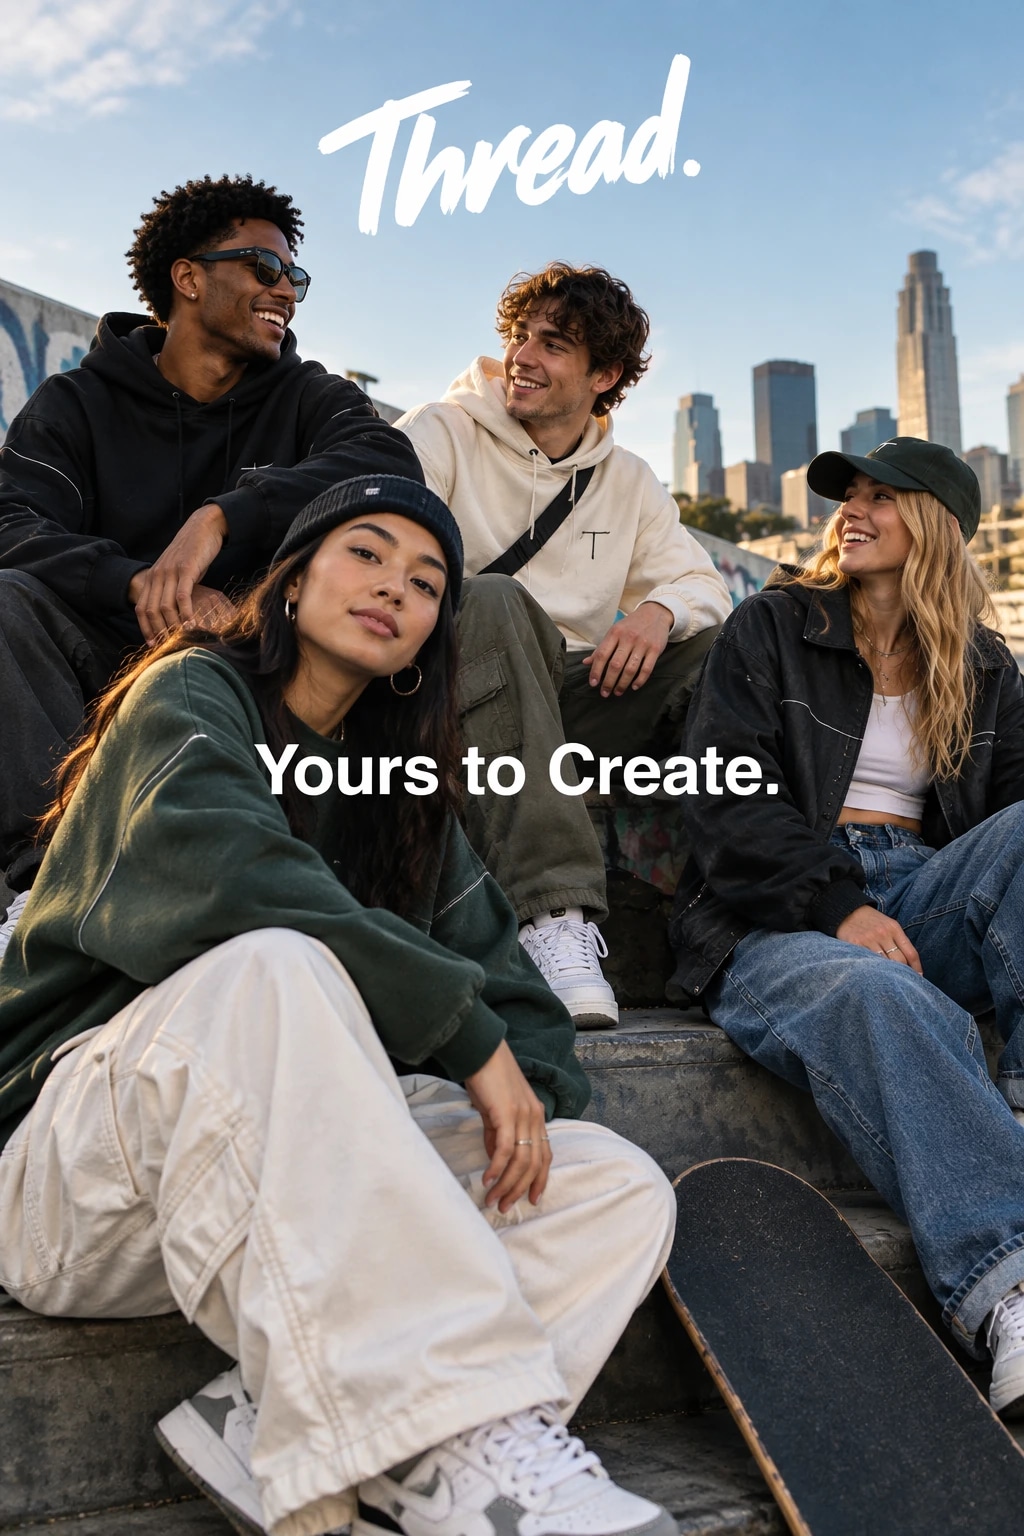
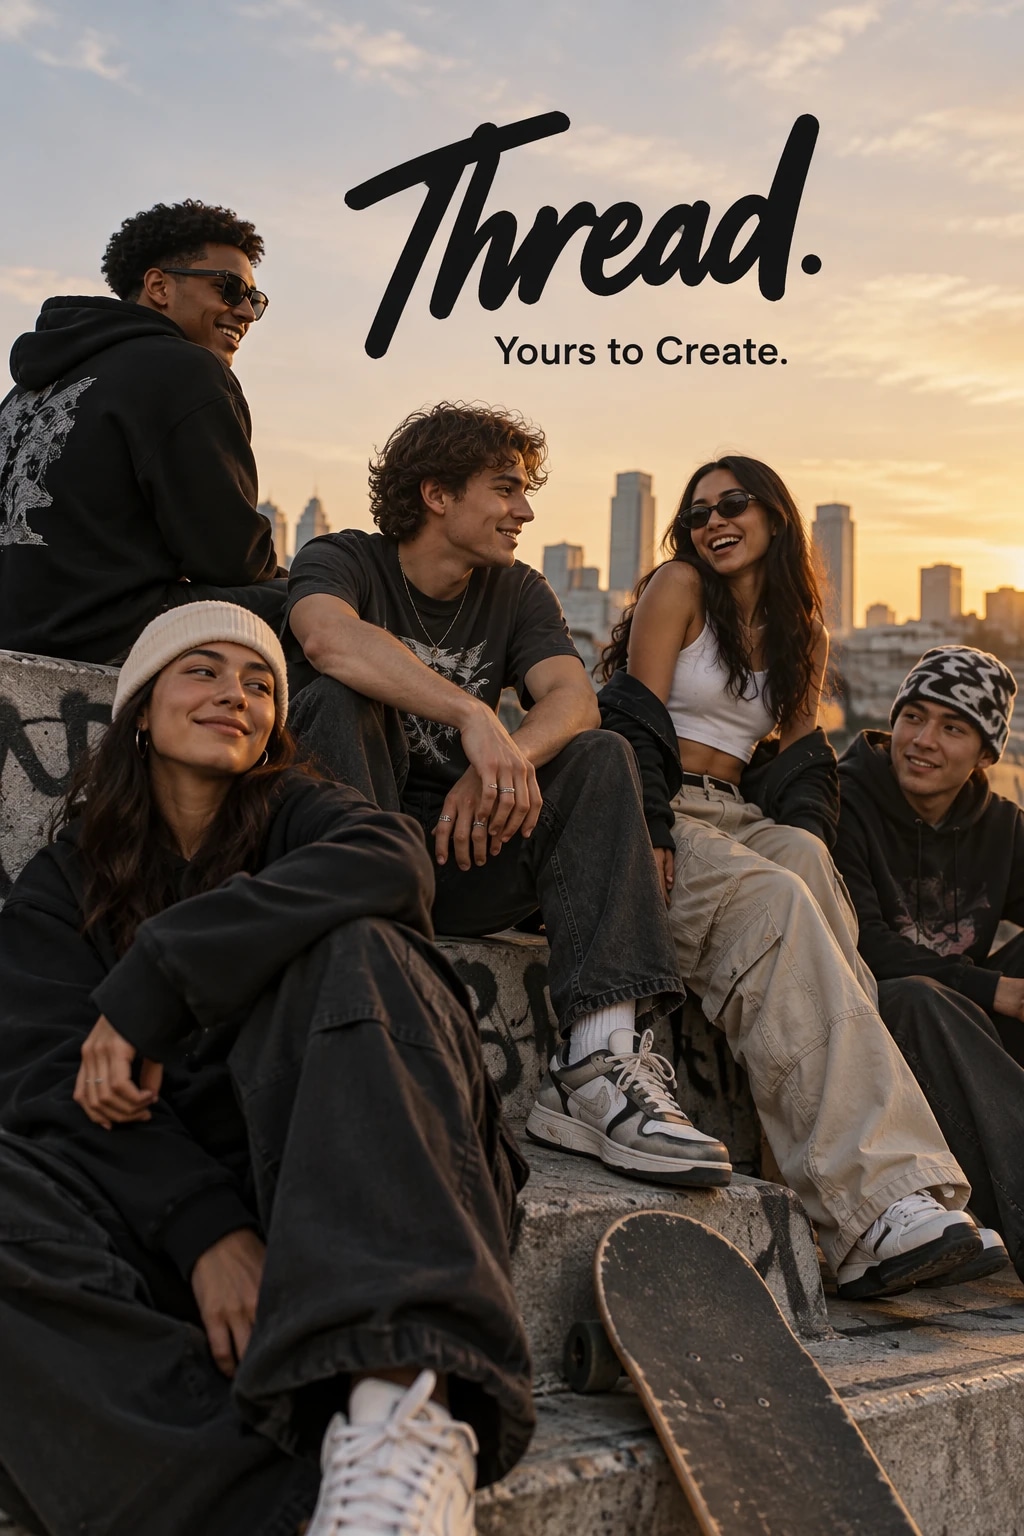
Слоган берём в кавычки и просим вывести его ровно один раз:
Сделай модный рекламный кадр для уличного бренда Thread.
Это молодой дерзкий стритвир-бренд. В кадре компания друзей
тусуется вместе, слоган "Yours to Create.".
Кадр как готовая рекламная кампания для молодёжной аудитории:
стильно, современно, энергично, со вкусом.
Чистая композиция, сильная работа с цветом, естественные позы,
приёмы премиальной fashion-фотографии.
Слоган ровно один раз, чётко и читаемо, вписан в макет.
Без лишнего текста, водяных знаков и посторонних логотипов.| Flare | Sunburst |
|---|---|
 |  |
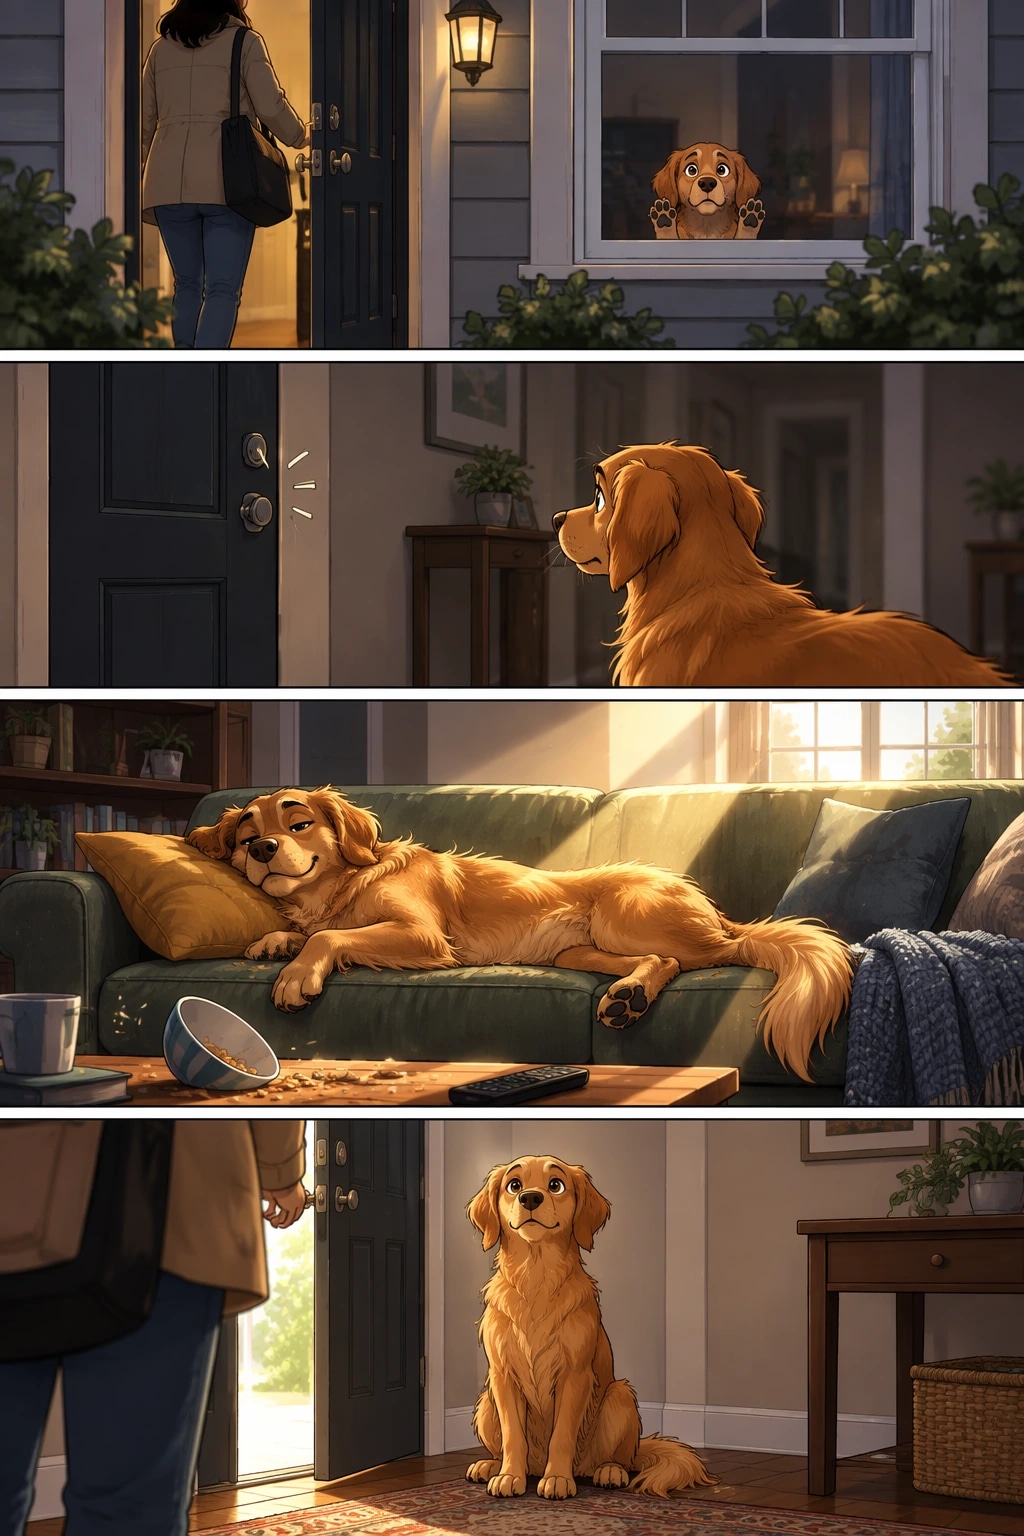
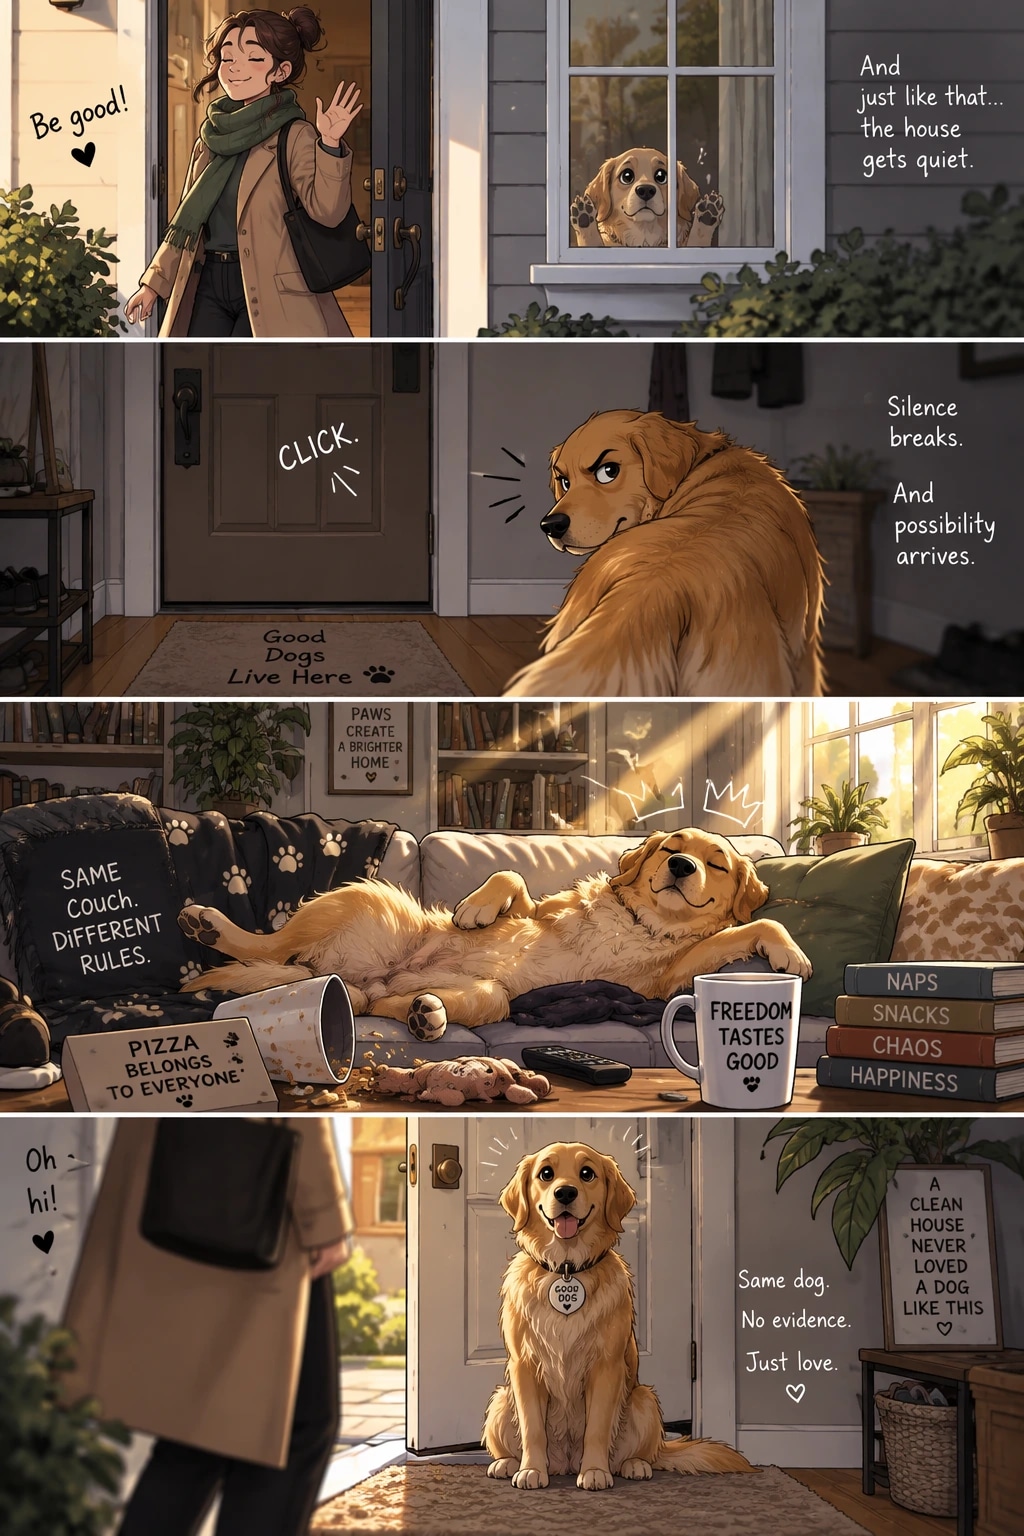
История задаётся списком конкретных кадров, по одному действию на панель:
Создай короткий вертикальный комикс из 4 панелей.
Панель 1: хозяин выходит через входную дверь. Питомец в окне за его
спиной, маленький на фоне стекла, глаза широко раскрыты.
Панель 2: дверь закрывается. Питомец медленно поворачивается к пустому
дому, взгляд полный возможностей.
Панель 3: дом преображён. Питомец развалился на диване как хозяин,
рядом крошки, солнце режет комнату как прожектор.
Панель 4: дверь открывается. Питомец сидит у входа, собранный
и невозмутимый, как будто ничего не было.| Flare | Sunburst |
|---|---|
 |  |
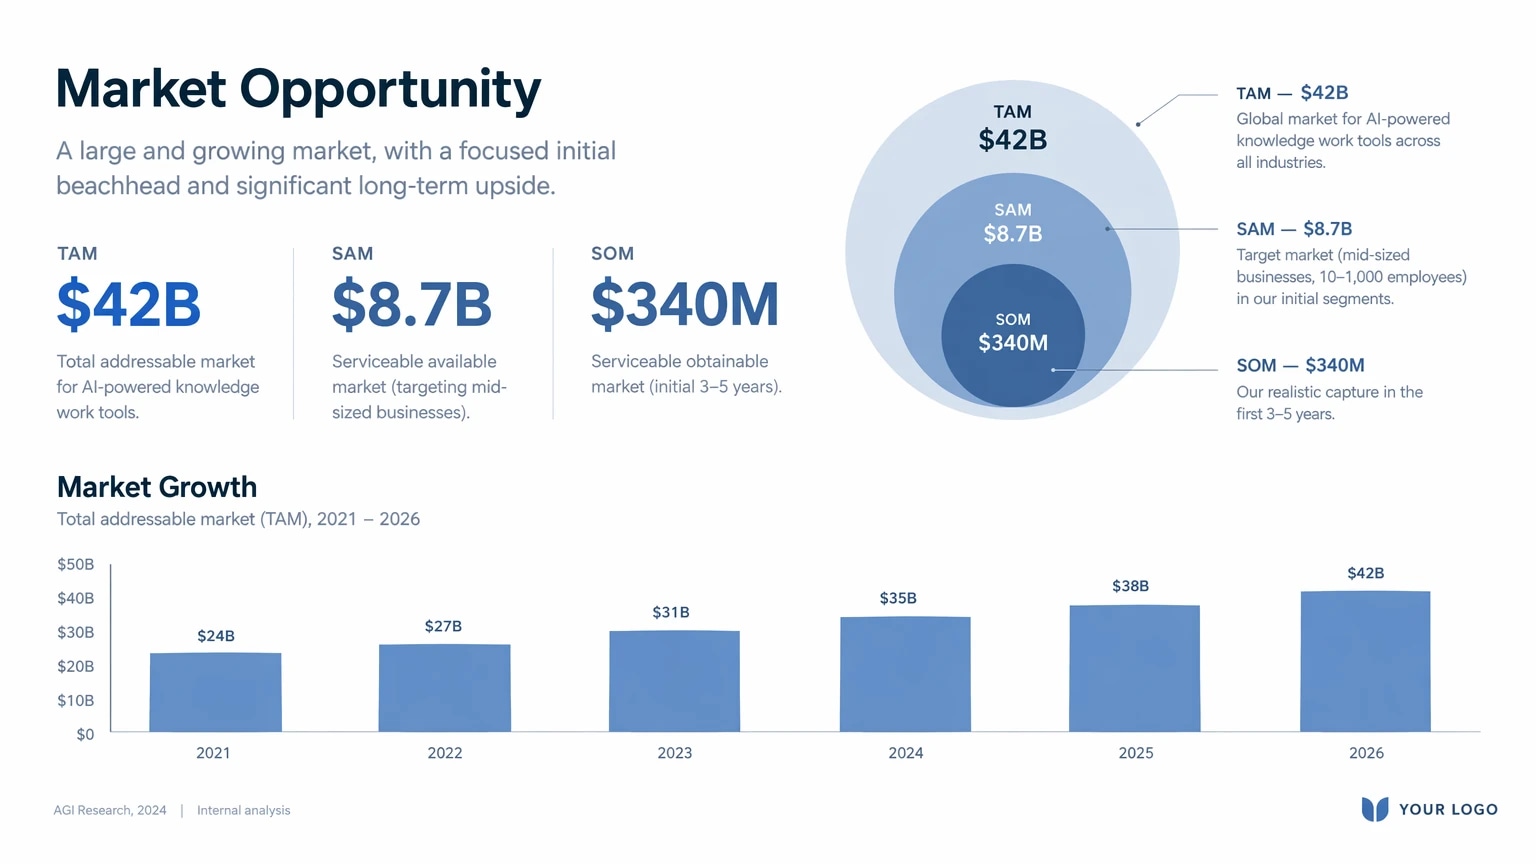
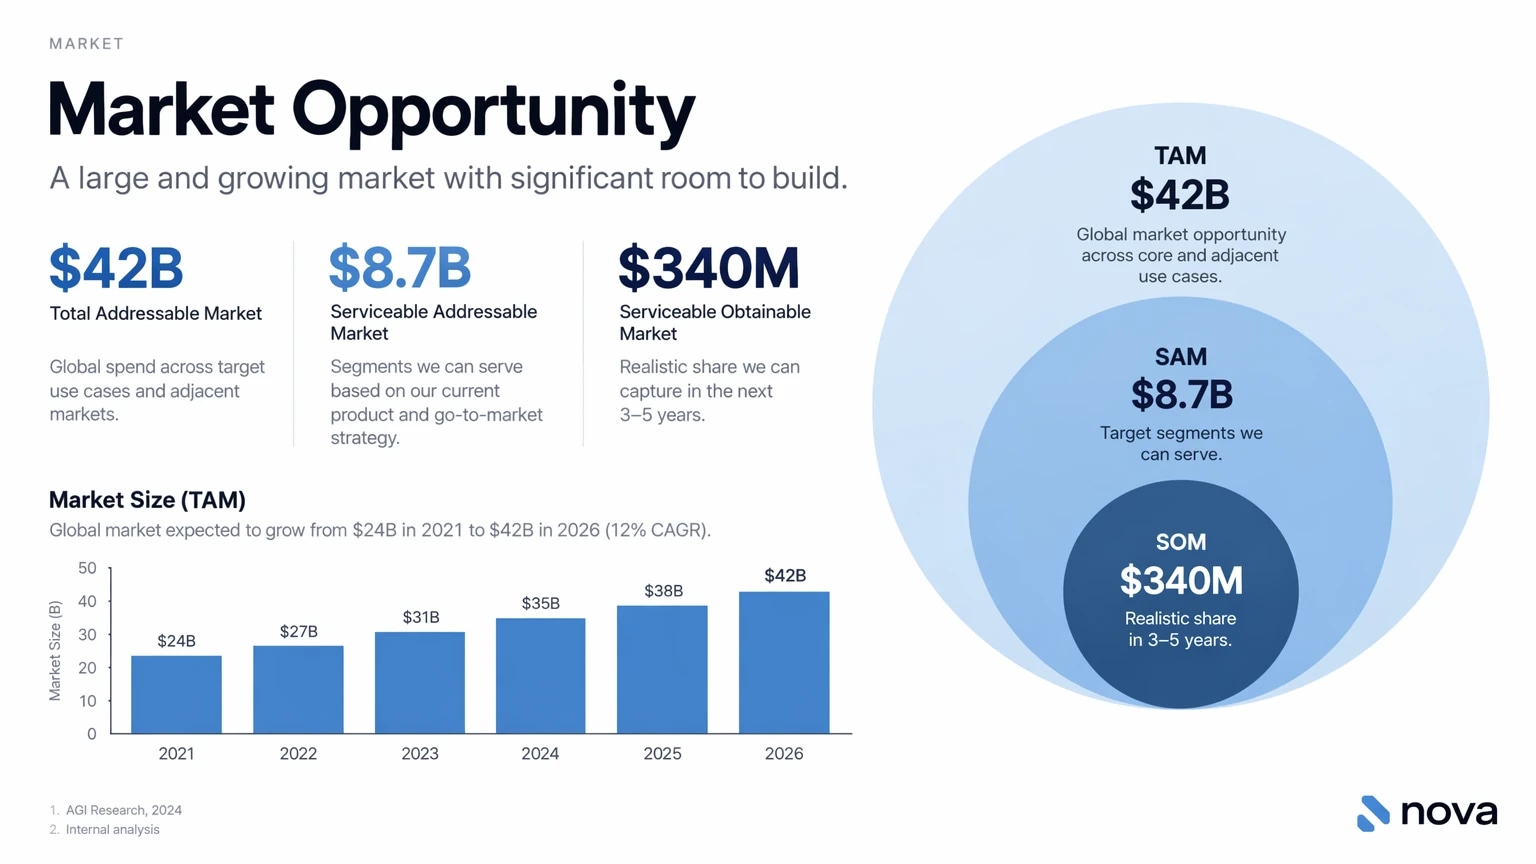
Для слайдов и диаграмм отдавайте модели реальные цифры и подписи, а не «какой-нибудь график». Текст, который должен оказаться на слайде, оставляем дословно:
Создай один слайд питч-дека с заголовком "Market Opportunity"
в стиле настоящего слайда серии A от стартапа из YC.
Чистый белый фон, современная гротеск-типографика вроде Inter,
минималистичная вёрстка. На слайде должны быть:
- Диаграмма TAM/SAM/SOM из концентрических кругов в приглушённых
  синих и серых тонах
- Правдоподобные цифры: TAM: $42B, SAM: $8.7B, SOM: $340M
- Столбчатый график роста рынка с 2021 по 2026 с лёгким восходящим
  трендом
- Мелкие сноски: "AGI Research, 2024" и "Internal analysis"
- Плейсхолдер логотипа в правом нижнем углу
Текст читаемый, данные с чёткой иерархией, аккуратные отступы.
Без клипарта, стоковых фото, градиентов и теней.| Flare | Sunburst |
|---|---|
 |  |
Для книги или комикса сначала фиксируем внешность героя одним изображением, а потом используем его как референс в следующих сценах, повторяя опорные детали.
Первый запрос, знакомим персонажа:
Создай иллюстрацию для детской книги, представляющую главного героя.

Персонаж:
юный герой в книжном стиле, похожий на маленького лесного разбойника,
в простой зелёной тунике с капюшоном, мягких коричневых сапогах
и с небольшим поясным мешочком. Доброе выражение лица, мягкие глаза,
смелый и тёплый характер. Держит маленький деревянный лук, которым
только помогает, но никому не вредит.

Тема:
персонаж защищает и спасает лесных зверей: белок, птиц, кроликов.

Стиль:
иллюстрация для детской книги, ручная акварель, мягкие контуры,
тёплые земляные цвета, сказочно и дружелюбно. Пропорции как в книжках
с картинками: чуть увеличенная голова, выразительное лицо.

Ограничения:
- оригинальный персонаж, без чужих героев
- без текста и водяных знаков
- простой лесной фон, чтобы персонаж читался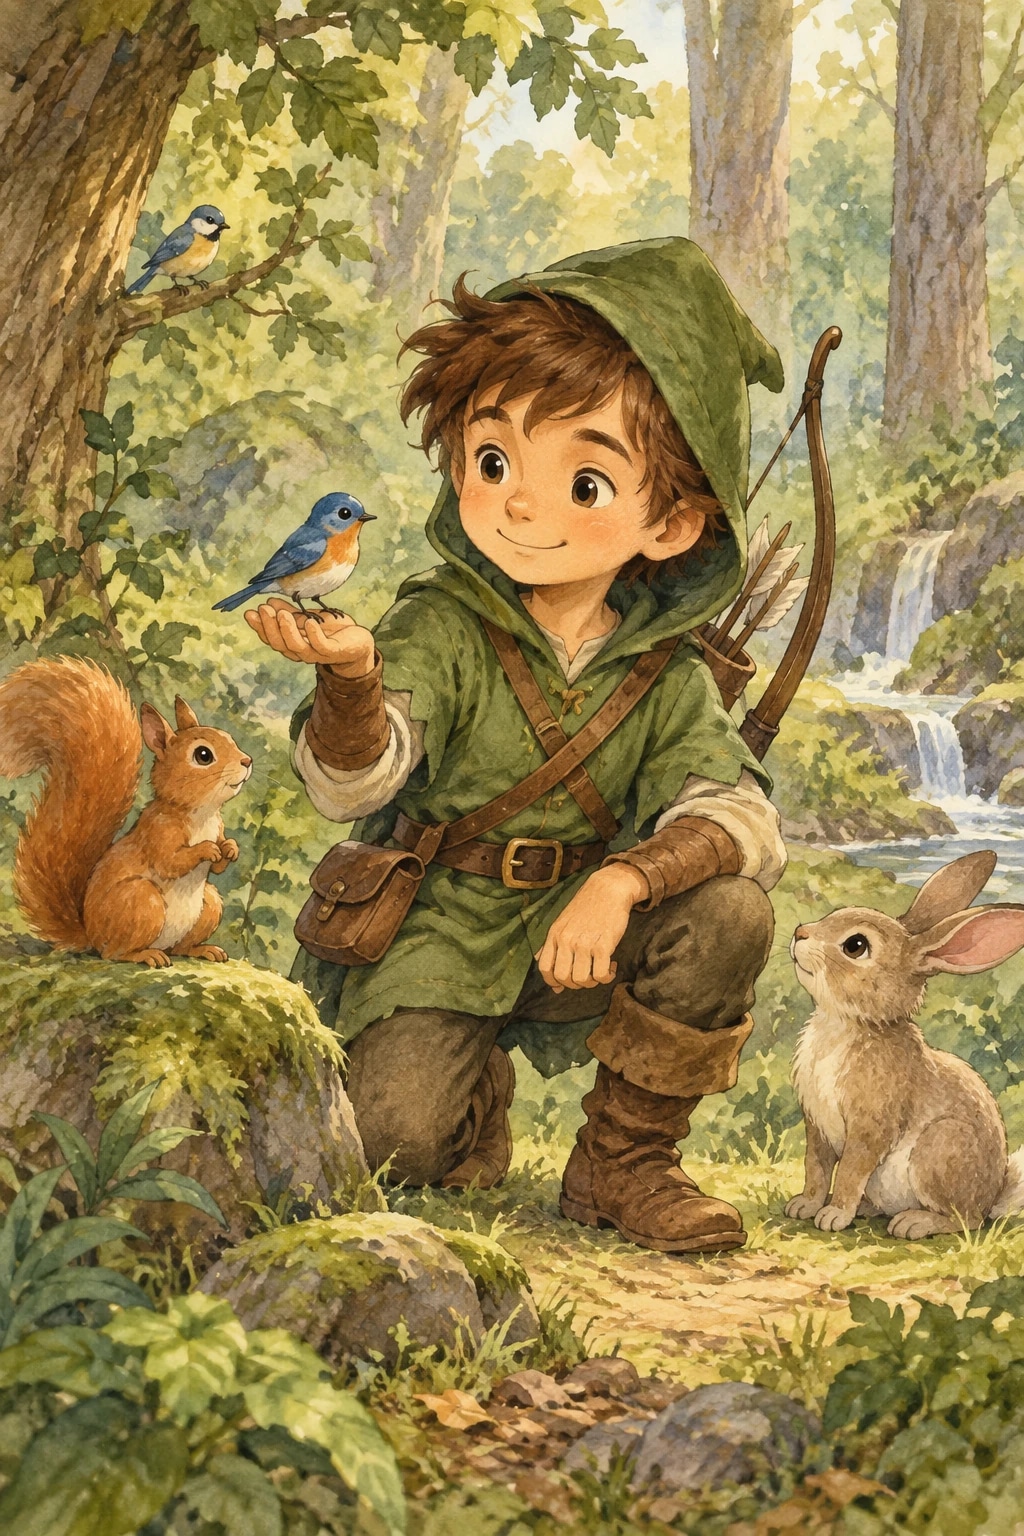
Второй запрос, продолжаем историю. Сгенерированный герой идёт в input_references, а в промпте повторяем, что должно совпасть:
Продолжи историю для детской книги с тем же персонажем.

Сцена:
тот же юный лесной герой бережно помогает напуганной белке выбраться
из упавшего дерева после зимней бури. Персонаж стоит на коленях рядом
с белкой и успокаивает её.

Консистентность персонажа:
- та же зелёная туника с капюшоном
- те же черты лица, пропорции и цветовая палитра
- тот же мягкий и героический характер

Стиль:
акварельная иллюстрация для детской книги, мягкий свет, заснеженный
лес, тёплое и уютное настроение.

Ограничения:
- не перерисовывай персонажа заново
- без текста и водяных знаков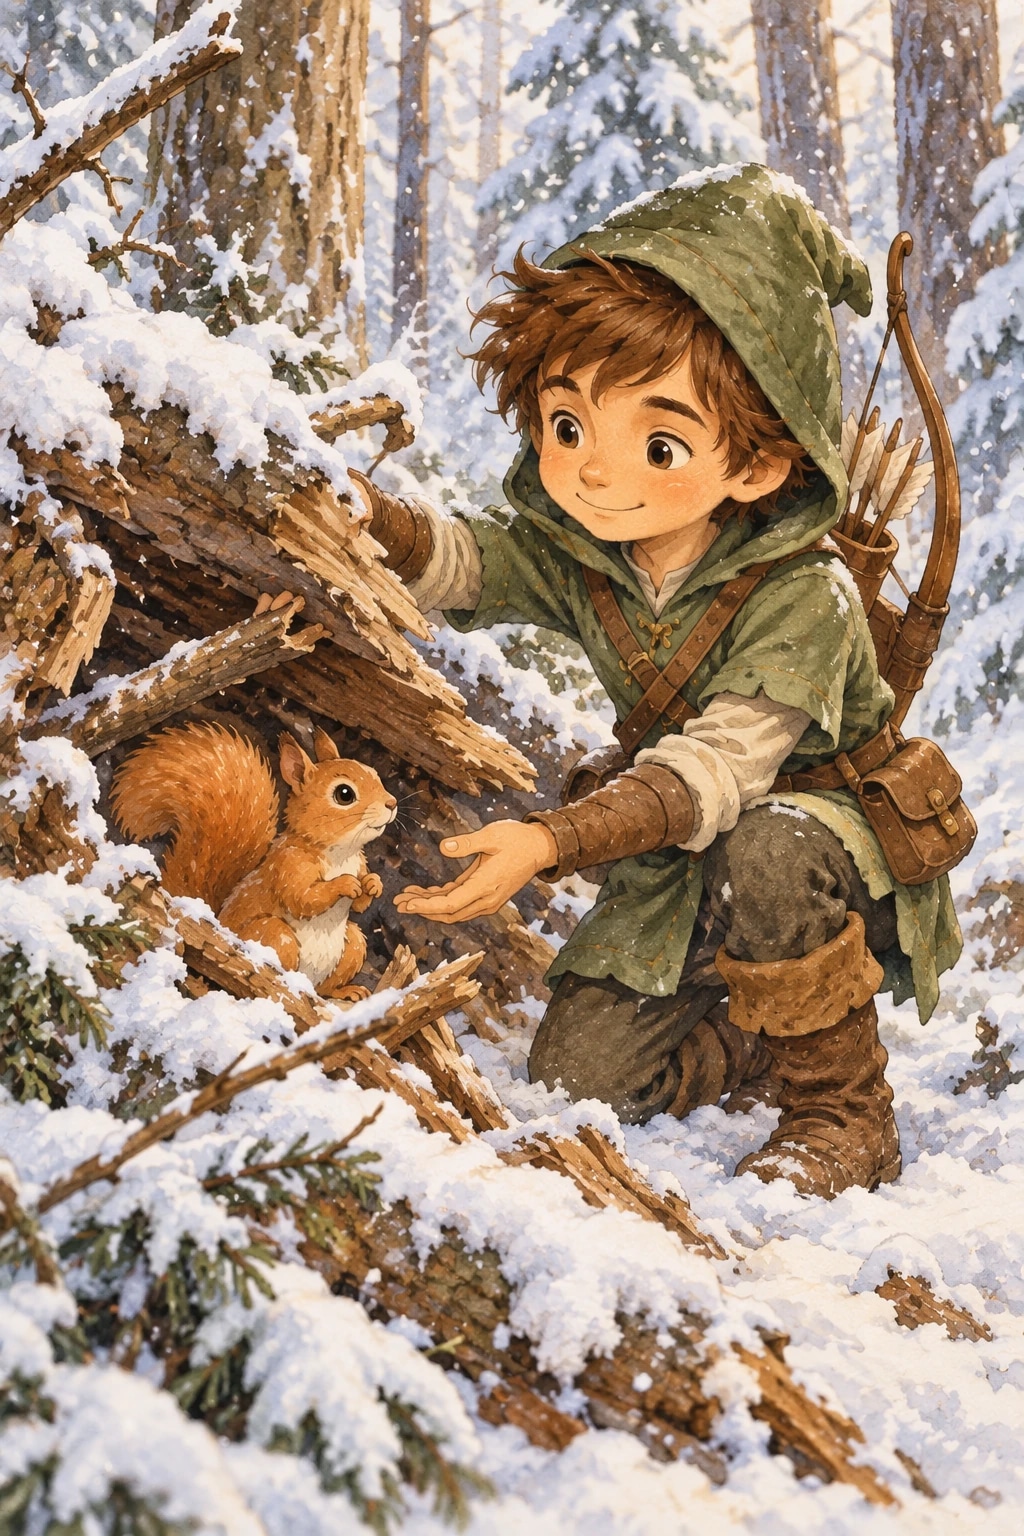
Список всех моделей генерации картинок с их параметрами:
curl "https://api.vega.chat/api/v1/images/models" \
  -H "Authorization: Bearer $VEGA_API_KEY"
По конкретной модели можно посмотреть провайдеров и тарифы:
curl "https://api.vega.chat/api/v1/images/models/openai/gpt-image-2.5-flare/endpoints" \
  -H "Authorization: Bearer $VEGA_API_KEY"
В ответе у каждого провайдера есть supported_parameters (точный список того, что эндпоинт принимает) и pricing. У GPT Image 2.5 тарификация за токены: входной текст и референсные картинки по одной ставке, выходная картинка по своей. Финальную сумму всегда удобнее смотреть в usage.cost готового ответа, чем считать руками.
По деньгам ещё один момент: биллинг генерации картинок работает по принципу «всё или ничего». Если генерация упала, деньги не списываются, а API возвращает ошибку. Частично оплаченных картинок не бывает.
b64_json декодируется в файл.openai/gpt-image-2.5-flare для черновиков и тестов промптов. Когда качество Flare перестанет устраивать, переходите на openai/gpt-image-2.5-sunburst с теми же промптами.usage.cost в ответах и не включайте xhigh/max без необходимости: почти все задачи закрываются на medium и high. API ВЕГА